Google 6 октября выпустила EmbeddingGemma 2, открытую модель для поиска по тексту, коду, изображениям, видео и аудио. Она позволяет создавать приложения, которые находят файлы по смыслу прямо на устройстве. Веса доступны для скачивания, но для работы с медиархивом понадобится готовое приложение или собственная настройка поиска.
Что изменилось во второй версии
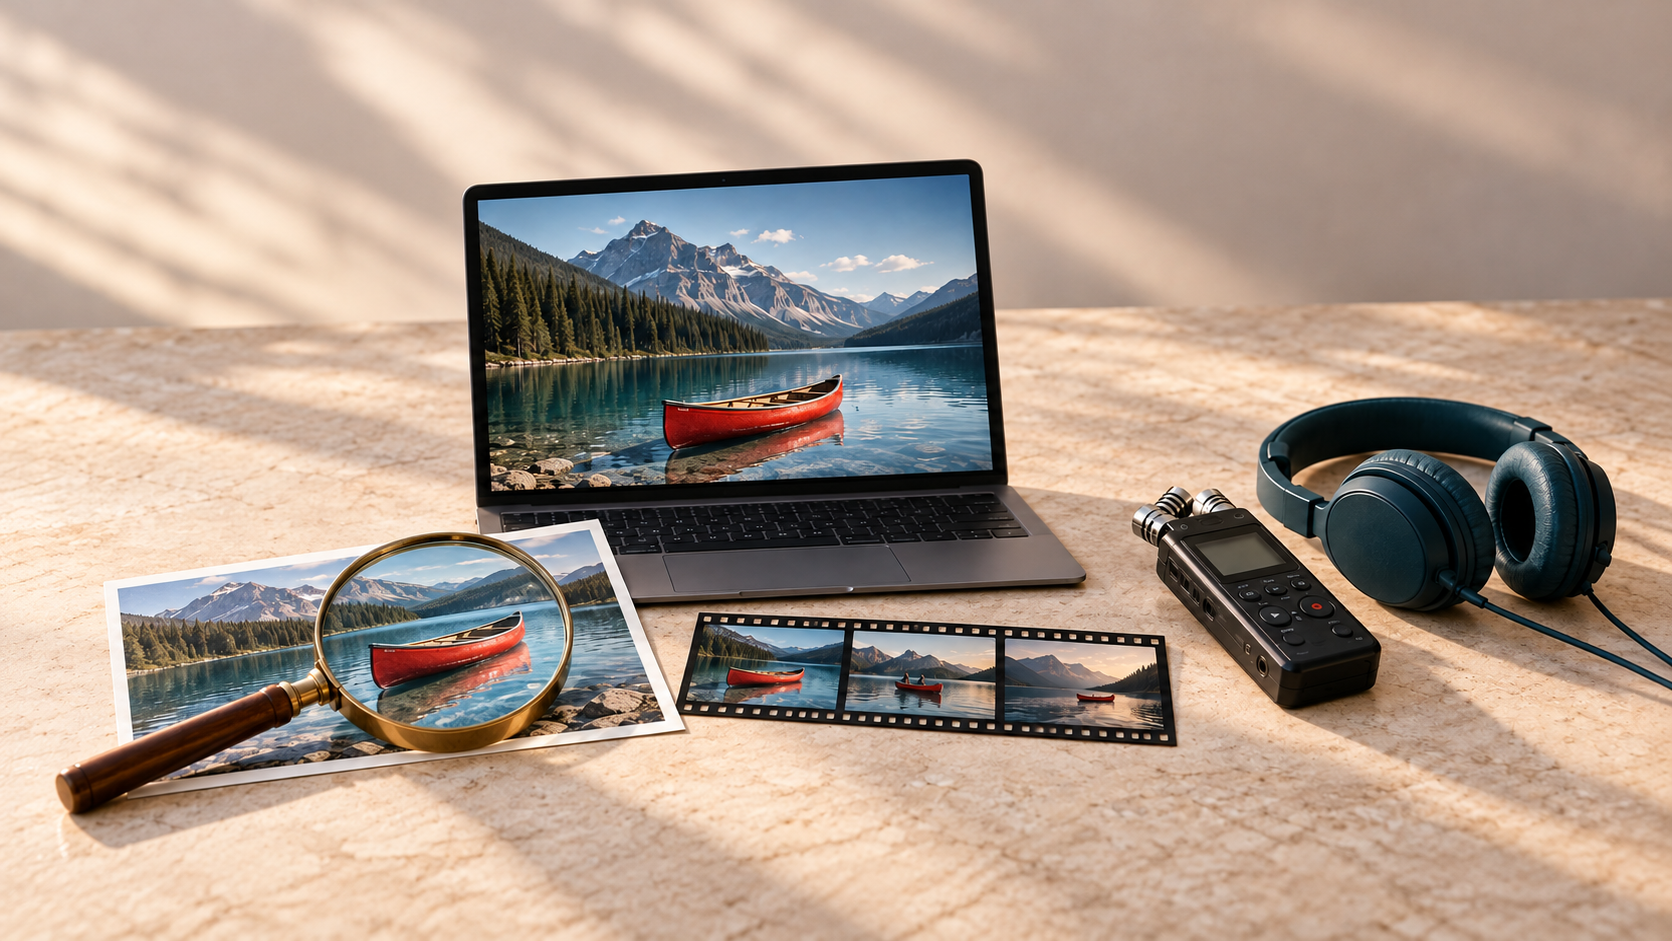
Первая EmbeddingGemma работала с текстом. Новая версия добавляет изображения, видео и звук в общее пространство поиска. Например, запрос словами можно сопоставить с содержимым фотографии, даже если нужные слова отсутствуют в названии файла.
Для этого модель превращает содержимое в эмбеддинг: список чисел, с которым приложение сравнивает другие файлы и поисковый запрос. Близкие по смыслу материалы оказываются рядом. На выходе получается основа для списка результатов; развёрнутый ответ на вопрос при необходимости пишет другая модель.
EmbeddingGemma 2 построена на технологиях семейства Gemma 4. Её можно использовать вместе с генеративной моделью: сначала найти подходящий фрагмент в локальных файлах, затем составить ответ с опорой на него. Такой подход называется RAG.
По измерениям Google, результат на наборе задач с кодом MTEB Code вырос с 68,76 до 78,68 балла. На многоязычном MTEB разница небольшая: 61,15 и 61,36. Главное изменение для медиархива связано с новыми типами данных.
Как это выглядит в медиархиве
Представим папку с материалами о поездке: фотографиями, видеозаписями и звуками природы. В приложении на EmbeddingGemma 2 можно искать кадры по описанию вроде «красная лодка на горном озере», а аудио по фразе «плеск воды у берега». Это пример сценария: конкретная выдача зависит от содержимого архива и качества модели.
Приложение сначала обрабатывает файлы и сохраняет их числовые представления в индексе. При новом запросе оно сравнивает его с этим индексом. Поэтому работа без облачной передачи файлов возможна после загрузки модели и подготовки данных. Само слово «локальный» ещё не гарантирует приватность любого стороннего приложения: отдельно важны его настройки, хранение индекса и сетевые функции.
В Google AI Edge Gallery компания показывает два готовых сценария. Instant Media Search ищет изображения и видео по тексту или картинке. Video Moments Finder находит подходящие моменты в локальном видео и показывает временные отметки. Google предлагает эти демонстрации в мобильном приложении для Android и iOS.
Сколько ресурсов нужно для локального поиска
Полная модель содержит 740 млн параметров, то есть числовых коэффициентов, полученных при обучении. Компоненты для изображения и звука можно отключить при загрузке. В руководстве разработчика описаны четыре конфигурации:
- 270 млн параметров для текста и кода
- 440 млн для текста, изображений и видеокадров
- 570 млн для текста и аудио
- 740 млн для полного мультимодального набора
Количество параметров не равно расходу оперативной памяти. Google приводит около 191 МБ активной RAM для текстовой части и около 567 МБ для полной модели на Pixel 11 Pro после квантизации, то есть уменьшения точности хранения чисел. Это результат конкретной оптимизированной сборки, а не минимальные требования к любому компьютеру.
Объём поискового индекса тоже можно менять. Стандартное представление содержит 768 чисел; поддерживаются сокращённые варианты на 512, 256 и 128. Более короткий вектор занимает меньше места, но может ухудшить поиск. Для изображений, видео и речи Google советует особенно внимательно проверять вариант на 128 чисел.
Где скачать и как попробовать
Веса опубликованы на Hugging Face. Google указывает лицензию Apache 2.0, допускающую использование модели в собственных проектах. В карточке также есть ссылка на правила допустимого применения Gemma. Для локального запуска не требуется оплачивать каждый запрос к API Google; вычисления и хранение обеспечивает ваше устройство.
Разработчикам доступен пример для Sentence Transformers. Он показывает загрузку модели, обработку медиа и сравнение результата с текстовым запросом. В руководстве запуска указана версия библиотеки 6.1.0 или новее. Для текстового поискового запроса используется режим SearchQuery, а изображения передаются как изображения, без текстового префикса.
С официального анонса можно перейти и к браузерной демонстрации на WebGPU. Для неё нужен совместимый браузер и графическое ускорение. В анонсе появление модели в Model Garden ещё обозначено как предстоящее.
Практический пример с рисунком
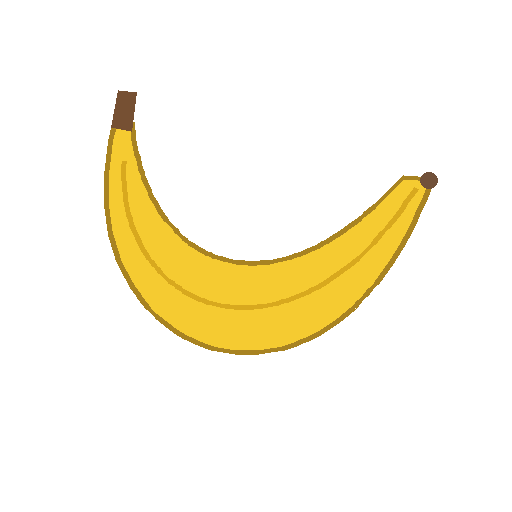
Мы отправили собственный простой рисунок банана в официальное демо Google Embedding Draw Challenge через его публичный API. Выбрали категорию Fruit и цель Banana. В ответе Banana занял первое место с игровым баллом 99,2%; далее оказались Pineapple с 41,5% и Orange с 32,6%.
Эти проценты относятся к шкале игры, а не к точности модели или вероятности правильного ответа. В демо изображение сравнивается с заданными английскими описаниями. Проверка выполнена на сервере демонстрации: она показывает сопоставление картинки и текста, но не измеряет скорость локального запуска или качество поиска на русском.
Какие ограничения важны до внедрения
У модели общий контекст на 8192 токена. В актуальной карточке EmbeddingGemma 2 приведены ориентиры для одного входа без сопутствующего текста: примерно 29 изображений, 58 видеокадров или 327 секунд аудио. При смешивании типов данных они делят один бюджет. Это не ограничение размера всего архива: приложение может индексировать файлы и фрагменты по отдельности.
Google заявляет поддержку более 100 языков, но предупреждает, что качество различается между ними. Поиск на русском стоит проверять на своих запросах, особенно если важны мелкие детали, похожие объекты или профессиональные термины.
При самостоятельном запуске важна и точность вычислений. Google рекомендует bfloat16 или float32 и предупреждает не использовать float16 для этой модели: в таком режиме возможны некорректные значения или незаметное ухудшение эмбеддингов. Пример из старого руководства для другой версии здесь может не подойти.
EmbeddingGemma 2 полезна тем, кто хочет построить единый поиск по разным локальным файлам. Открытые веса уже позволяют начать разработку. Владельцу обычного фотоархива проще сначала проверить готовую демонстрацию и качество выдачи на небольшом наборе, а затем решать, нужен ли полноценный локальный индекс.