- Что такое Ultrafast и чем он отличается от модели
- Что ускоряется и почему нет общей гарантии в секундах
- Кому доступен режим и какие есть лимиты
- Сколько стоит GPT-6.1 Sol Ultrafast
- Пример Standard и Ultrafast по документации
- Когда нужен WebSocket
- Что проверить перед переходом
- Главное для пользователя и разработчика
8 октября 2026 года OpenAI добавила Ultrafast для GPT-6.1 Sol в Responses API. Режим сокращает интервалы между генерируемыми токенами, то есть небольшими фрагментами ответа. Он доступен пользователям API с учётом лимитов. Для владельца приложения это возможность быстрее выдавать текст, но с более высокой стоимостью обработки. Дата запуска указана в журнале изменений OpenAI.
Разберём, где можно ожидать пользу, как выглядит переключение Standard → Ultrafast и почему скорость всего приложения нужно проверять отдельно. Пример ниже составлен по документации: платные запросы не выполнялись, результатов собственного теста здесь нет. Условия перепроверены 15 октября 2026 года.
Что такое Ultrafast и чем он отличается от модели
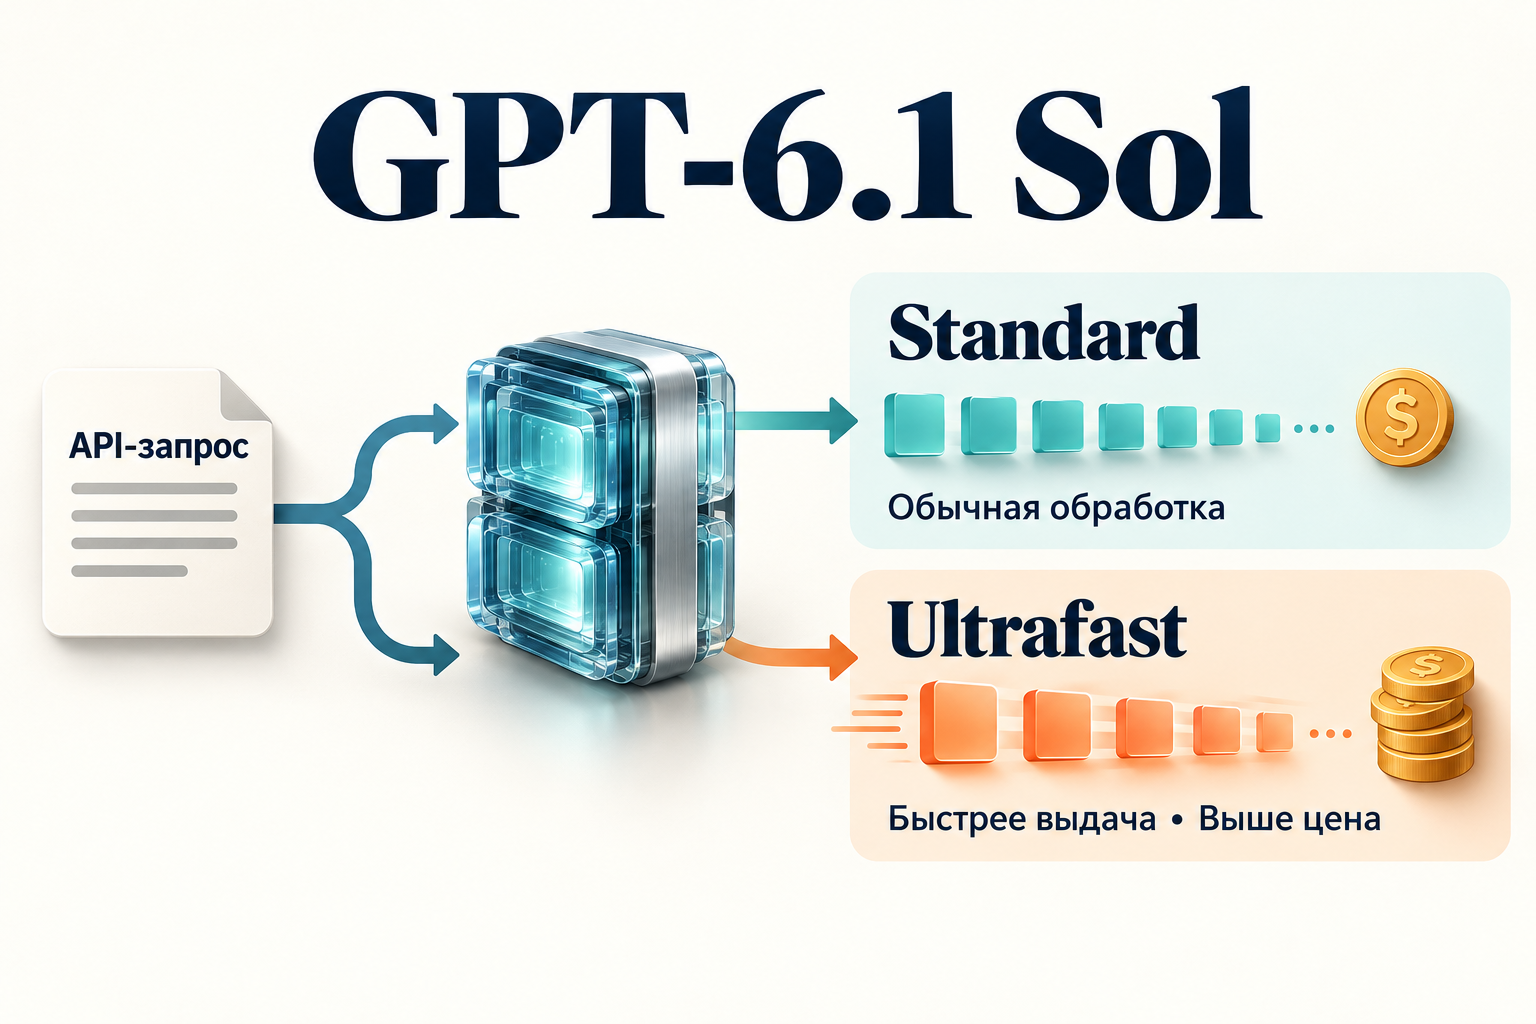
GPT-6.1 Sol выполняет задачу, а Ultrafast задаёт уровень обслуживания запроса. Название модели в настройках остаётся gpt-6.1-sol. Переключается параметр service_tier, который определяет режим обработки в API. В руководстве OpenAI Ultrafast назван самым быстрым сервисным уровнем.
API позволяет вашему сайту, боту или другой программе обращаться к модели. Responses API — один из интерфейсов для таких обращений. Настройку обычно меняет разработчик приложения. Само появление режима в API не означает, что у подписчика ChatGPT появился бесплатный переключатель ускорения или что все сторонние сервисы уже его включили.
Что ускоряется и почему нет общей гарантии в секундах
В описании запуска OpenAI говорит об уменьшении времени между выходными токенами. Это конкретная характеристика выдачи текста. Из неё нельзя вывести, что любой ответ придёт за фиксированное число секунд или что приложение станет быстрее в одинаковое число раз.
У ожидания есть несколько разных частей:
- Время до первого фрагмента. Пользователь уже отправил задачу, но ещё не увидел начала ответа.
- Выдача продолжения. После начала ответа модель постепенно генерирует остальной текст.
- Полное время задачи. Сюда входят также передача данных, обращения к внешним сервисам и обработка результата вашим приложением.
Допустим, помощник мастерской сначала ищет свободное время в системе записи, затем пишет ответ клиенту. Быстрая генерация текста сама по себе не устраняет ожидание системы записи. Это иллюстрация устройства процесса, а не замер Ultrafast. В руководстве по задержкам OpenAI отдельно советует сокращать лишние запросы и объём ответа: каждый сетевой обмен добавляет время.
Чтобы посетитель видел текст по мере появления, приложению нужен потоковый вывод, или streaming. В HTTP-запросе он включается через stream: true. Без него приложение может дождаться всего ответа и лишь потом показать текст. Эти варианты описаны в документации streaming; потоковый вывод и платный уровень обработки настраиваются отдельно.
Кому доступен режим и какие есть лимиты
По состоянию на 15 октября руководство указывает доступность Ultrafast для всех пользователей API. У него собственные ограничения интенсивности использования, отдельные от Standard и Fast. Для GPT-6.1 Sol приведены базовые лимиты:
| Уровень использования API | Токенов в минуту |
|---|---|
| Build | 1 000 000 |
| Launch | 4 000 000 |
| Grow | 40 000 000 |
Это ограничения потока запросов, не бесплатный пакет и не скорость одного ответа. Проверяйте лимиты своей организации. Для Sol поддерживаются глобальная обработка и размещение данных в США или ЕС. Источник: раздел Availability. Условия регионального размещения и общие правила доступа к платформе сохраняются.
Сколько стоит GPT-6.1 Sol Ultrafast
В официальном прайс-листе на 15 октября указаны такие цены в долларах США за миллион токенов для запросов с входом до 272 тысяч токенов включительно:
| Категория токенов | Standard | Ultrafast |
|---|---|---|
| Входные | $2 | $12 |
| Входные из кеша | $0,10 | $0,60 |
| Запись в кеш | $2,50 | $15 |
| Выходные | $10 | $60 |
Кеш позволяет повторно использовать уже обработанную часть входных данных; для чтения и записи в него предусмотрены отдельные категории. Их не нужно механически складывать для каждого токена. Ultrafast стоит в шесть раз дороже Standard при сопоставимых условиях. Этот множитель относится к цене, а не к ускорению.
Для входа свыше 272 тысяч токенов действуют другие ставки на весь запрос. Региональная обработка добавляет 10% к тарифу. Эти условия также перечислены в карточке GPT-6.1 Sol. Итог зависит от фактического расхода токенов и используемых инструментов, поэтому таблица не является ценой одного сообщения.
Пример Standard и Ultrafast по документации
Ниже учебные конфигурации, а не выполненный тест. В обоих вариантах модель получает одинаковое задание: сократить учебный факт-лист творческой мастерской «Линия» до 80 слов, сохранив шесть условий. Используются один и тот же текст, ограничение вывода и настройка рассуждения. Меняется только service_tier.
Standard — тело запроса к POST /v1/responses:
{
  "model": "gpt-6.1-sol",
  "service_tier": "default",
  "reasoning": {"effort": "low"},
  "max_output_tokens": 2048,
  "stream": true,
  "input": "Сократи факт-лист творческой мастерской «Линия» до 80 слов, сохрани все 6 условий: 1) Работаем вт–сб с 10:00 до 18:00. 2) Занятие длится 90 минут. 3) Группа — до 8 взрослых. 4) Стоимость — 1200 рублей. 5) Материалы включены. 6) Запись — за 24 часа. Не добавляй новых фактов, условий доставки или скидок."
}
Ultrafast — то же задание с другим уровнем обслуживания:
{
  "model": "gpt-6.1-sol",
  "service_tier": "ultrafast",
  "reasoning": {"effort": "low"},
  "max_output_tokens": 2048,
  "stream": true,
  "input": "Сократи факт-лист творческой мастерской «Линия» до 80 слов, сохрани все 6 условий: 1) Работаем вт–сб с 10:00 до 18:00. 2) Занятие длится 90 минут. 3) Группа — до 8 взрослых. 4) Стоимость — 1200 рублей. 5) Материалы включены. 6) Запись — за 24 часа. Не добавляй новых фактов, условий доставки или скидок."
}
Для Standard явно задано значение default: если параметр пропустить, применяется auto, который учитывает настройки проекта. max_output_tokens ограничивает сумму видимых токенов ответа и токенов рассуждения; это не счётчик слов. Оба правила описаны в справочнике создания Responses-запроса. Значение low поддерживается Sol; выбор здесь учебный и не означает, что он оптимален для любой задачи.
Для выполнения запроса нужны действующий доступ к API и бюджет на использование. Конфигурации не содержат ключа, не создают аккаунт и ничего не запускают сами по себе. В статье нет сгенерированного ответа мастерской: без реального запуска его нельзя выдавать за результат модели.
Когда нужен WebSocket
HTTP подходит для отдельного запроса. Для агента, который часто вызывает инструменты, OpenAI рекомендует постоянное соединение WebSocket: сетевые накладные расходы могут уменьшить выигрыш от генерации. Оба способа описаны в руководстве Ultrafast.
Для владельца сайта практический вопрос звучит так: какая часть ожидания приходится на модель? Если посетитель ждёт длинный текст, ускоренная выдача может быть полезна. Если задача упирается в медленный поиск по базе или сторонний сервис, сначала стоит проверить этот участок. Это критерий выбора, а не подтверждение выигрыша конкретного приложения.
Что проверить перед переходом
Для обоснованного решения нужен отдельный тест на собственных задачах. Сравнивать стоит одинаковую модель, входные данные, настройку рассуждения, лимит ответа и способ соединения. Одного удачного запроса недостаточно.
- Запишите время до первого видимого фрагмента и полное время ответа отдельно.
- Повторите задания серией и сравните типичные значения и медленные случаи.
- Проверьте качество: в нашем учебном задании должны сохраниться все шесть условий.
- Учтите фактический расход, стоимость и ошибки превышения лимитов.
Такой тест следует планировать с заранее выбранным бюджетом. В этом материале он не проводился, поэтому численных обещаний скорости нет.
Главное для пользователя и разработчика
Ultrafast для GPT-6.1 Sol появился в Responses API 8 октября. Рассматривать его имеет смысл, когда ожидание ответа мешает работе и экономия времени оправдывает более высокий тариф. Начать можно с проверки устройства своего приложения и документальной конфигурации выше. Переходить на платный режим для всех запросов разумно после измерений, а пользователю готового сервиса стоит уточнить у его разработчика, используется ли Ultrafast вообще.