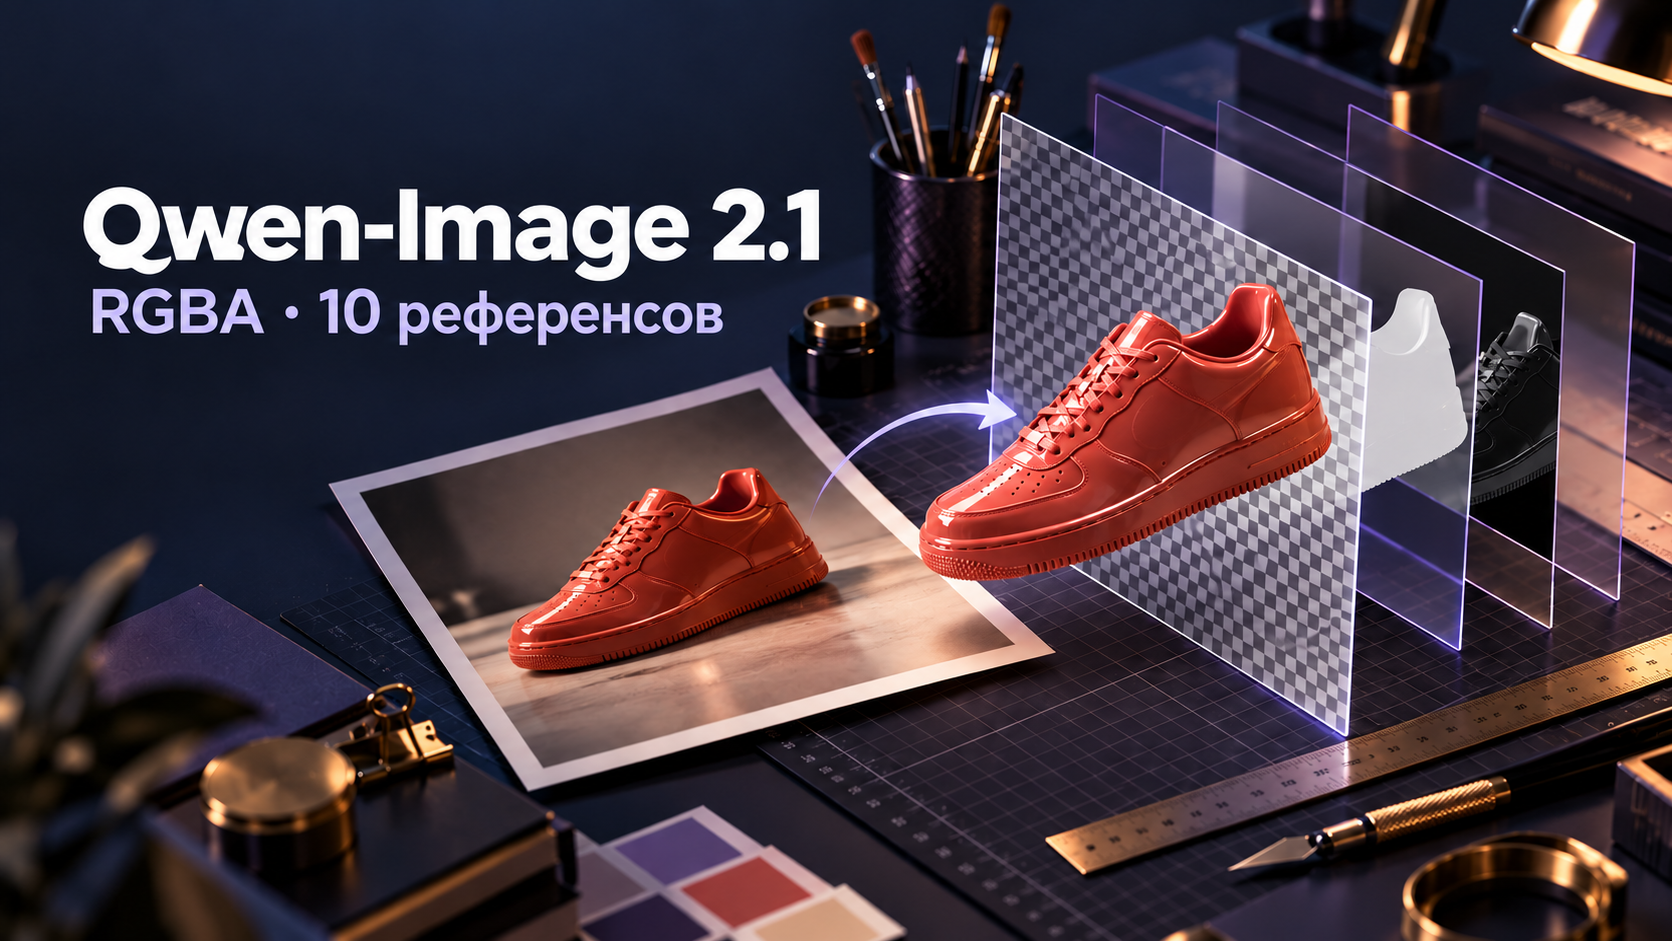
20 сентября команда Qwen выпустила Qwen-Image‑2.1 — модель для создания и редактирования изображений. Она умеет сразу выдавать файл с прозрачным фоном, собирать сцену из десяти референсов и менять отдельные области картинки. Веса доступны для загрузки, но условия лицензии ограничивают коммерческое применение.
Что нового в Qwen-Image‑2.1
Предыдущая Qwen-Image‑2.0 уже объединяла генерацию и редактирование. В версии 2.1 команда развила эту идею: к обычному изображению можно добавить настоящий альфа-канал, работать с прозрачными элементами и использовать больше исходных материалов при сборке новой сцены. В официальном анонсе также выделены более аккуратная типографика, свет на портретах и детали материалов.
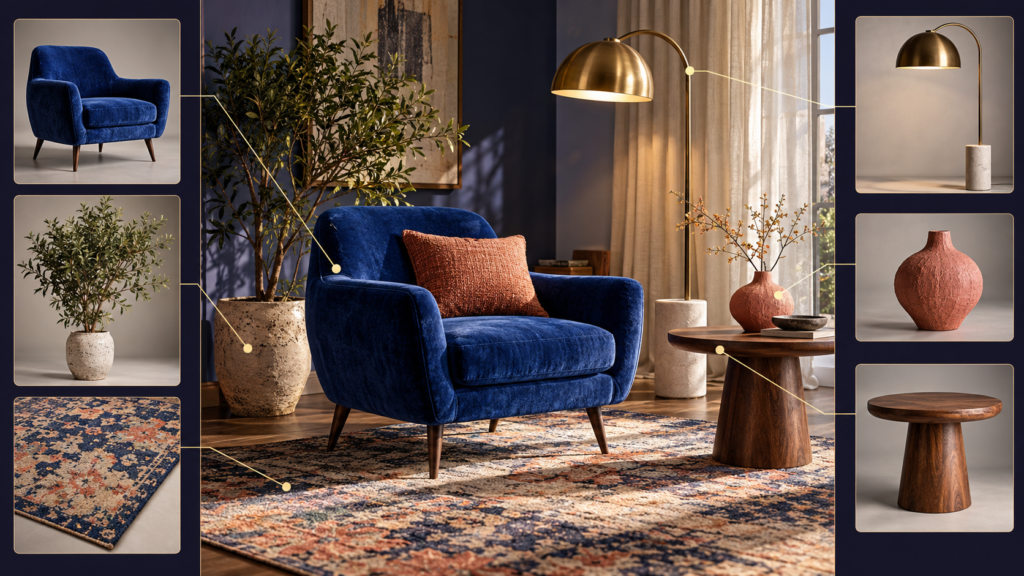
Это модель для визуальной работы, а не новая версия текстового чат-бота Qwen. В одном интерфейсе она принимает описание сцены, исходную фотографию или набор референсов и возвращает готовое изображение. Среди показанных командой задач — рекламные макеты, предметные изображения, панорамы, раскадровки и иллюстрации для дизайна интерьера.
| Возможность | Как это работает в версии 2.1 |
|---|---|
| Создание | Изображение по текстовому запросу; обычный фон или прозрачность |
| Редактирование | Изменение готового изображения и его отдельных областей |
| Референсы | До десяти входных изображений для одной композиции |
| Разрешение | Нативное семейство размеров 2K, включая широкоформатный кадр |
| Доступ | Веса, демонстрация и инструменты для локального запуска |
Прозрачный фон без отдельного удаления
Одна из главных новинок — генерация RGBA-изображений. У такого файла есть цветовые каналы и альфа-канал, который задаёт прозрачность каждого пикселя. Поэтому нарисованный объект можно положить поверх другого фона, не вырезая его вручную и не маскируя белую подложку.
Модель может создать наклейку, предмет или композицию сразу на прозрачном фоне. Затем тот же файл можно редактировать: изменить выражение персонажа или надпись и сохранить прозрачность. Из обычной фотографии Qwen-Image‑2.1 также умеет выделять объект в отдельный RGBA-слой. Для дизайнера это сокращает число переходов между генератором, инструментом удаления фона и редактором.
Отдельная Qwen-Image-Layered уже работала с прозрачными слоями. Теперь эта возможность вошла в единую модель генерации и редактирования. В инструкции к весам приведён пример запроса для прозрачного результата и сохранения PNG с альфа-каналом.
Десять референсов и точечные правки
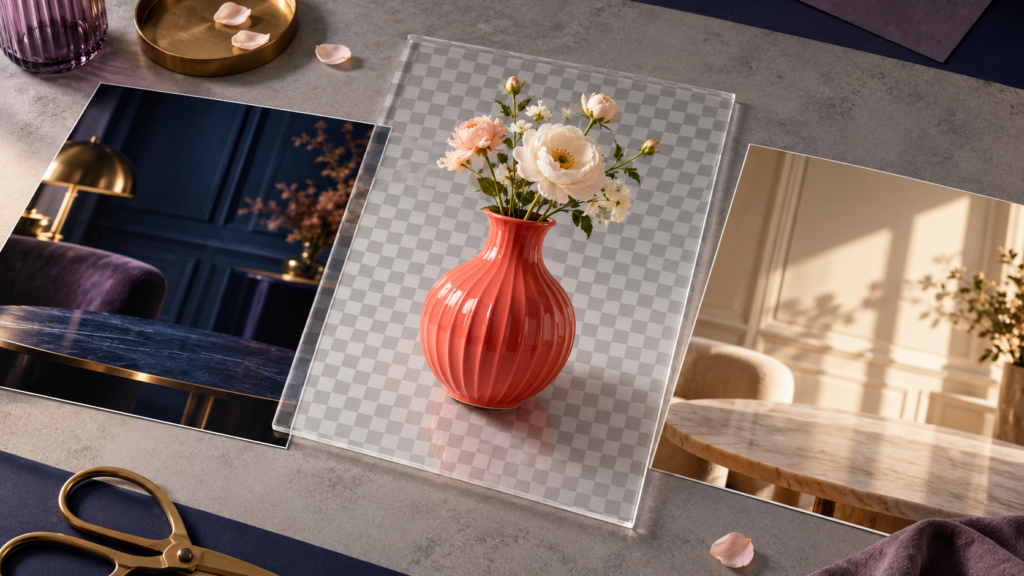
Qwen-Image‑2.1 принимает до десяти исходных изображений для одной задачи. Например, можно загрузить фотографии мебели и попросить собрать интерьер, или соединить снимки модели, одежды и аксессуаров в один образ. В анонсе показано и объединение шести отдельных портретов в групповую фотографию.
При редактировании можно обозначить нужную область цветным кругом, закрасить её поверх исходника или передать отдельную маску. В демонстрации команда одновременно убирает часы, меняет цвет волос и заменяет одежду в трёх отмеченных местах. Отдельная маска удобна, когда разметка поверх фотографии закрывает важные детали.
Разработчики также уделили внимание сохранению узнаваемых черт человека и внешнего вида товара между правками: формы, фактуры и надписей на упаковке. Это особенно важно для серии кадров, карточек товара и макетов, где новая сцена должна использовать один и тот же предмет. Для многошаговой работы можно менять сцену последовательно, сохраняя уже готовые части изображения.
Как устроена модель и что изменилось в качестве
Визуальный генератор Qwen-Image‑2.1 содержит 7 млрд параметров и 32 слоя диффузионного трансформера. Отдельно используется Qwen3-VL на 8 млрд параметров: он обрабатывает текстовые инструкции и изображения, переданные в качестве условий. Поэтому цифра 7 млрд относится именно к компоненту генерации, а не ко всем частям системы.
Автоэнкодер работает с 64-канальным представлением RGBA и сжимает изображение по пространственным измерениям в 16 раз. Для широкого кадра в примерах запуска рекомендован размер 2752 × 1536 пикселей, для квадратного — 2048 × 2048. Поддерживаются и вертикальные пропорции, так что модель годится как для обложки, так и для плаката или карточки.
В вычислениях при редактировании несколько фотографий есть практическая оптимизация: модель повторно использует сохранённые ключи и значения для неизменных входных изображений и инструкции. При последовательном создании кадра эти данные не приходится заново считать на каждом шаге. Команда связывает с этим ускорение работы с несколькими референсами.
Qwen отдельно показывает более выразительные фактуры, освещение и работу с текстом внутри изображения. Новая версия рассчитана не только на фотореализм: среди примеров есть сложные плакаты, инфографика и раскадровка по трём видам персонажа. Для рабочего макета текст и логотип всё равно лучше вычитать глазами перед публикацией — ошибки в отдельной надписи могут испортить готовый материал.
Как попробовать Qwen-Image‑2.1
Самый простой способ посмотреть на возможности — демонстрация на Hugging Face. Веса модели опубликованы на Hugging Face и ModelScope. Для запуска на собственном оборудовании команда даёт примеры генерации и редактирования через Diffusers; ComfyUI поддерживает модель и предлагает готовые рабочие процессы.
Для разработчиков в репозитории описаны интеграции с vLLM-Omni и SGLang, а также перенос части вычислений с видеокарты в оперативную память. Последний вариант помогает при ограниченной памяти GPU, но увеличивает требования к остальной системе и может замедлить работу. Простая веб-демонстрация позволит оценить результат без установки многогигабайтных весов.
Отдельный тариф и идентификатор API для Qwen-Image‑2.1 Alibaba Cloud Model Studio пока не объявила. Проверить модель сейчас можно в веб-демонстрации или через опубликованные веса; цены API предыдущей Qwen-Image‑2.0 относятся к другой версии.
Лицензия ограничивает коммерческое использование весов
Веса Qwen-Image‑2.1 доступны публично, однако они выпущены по Qwen Research License Agreement. Документ разрешает использование материалов для исследований и оценки. Для применения самих весов в коммерческом продукте требуется отдельная коммерческая лицензия от правообладателя.
Это существенная деталь для студий, сервисов генерации и компаний, которые планируют разворачивать модель на своих серверах. Доступность файлов для скачивания сама по себе не даёт права встроить их в платный сервис. Предыдущие версии семейства распространялись на других условиях, поэтому для Qwen-Image‑2.1 нужно ориентироваться на её собственный лицензионный файл.
Что даёт обновление пользователю
Qwen-Image‑2.1 удобнее всего оценивать на задачах, где изображение нужно не только создать, но и довести до готового макета. Прозрачный PNG сокращает работу с вырезанием предмета; десять референсов помогают собрать сцену из конкретных исходников; маска и пометки позволяют исправить нужный участок без пересоздания всей композиции.
Релиз дополняет уже существовавшую в Qwen-Image‑2.0 связку генерации и редактирования. Теперь в центре внимания прозрачные элементы, точечное управление и сохранение деталей при повторных правках. Для личных экспериментов доступны демо и веса; при коммерческом развёртывании ключевым решением станет получение подходящей лицензии.