- Что означает локальный запуск DeepSeek
- Полные модели DeepSeek и требования к серверу
- Небольшие R1-distill и квантизация
- Сколько RAM и видеопамяти нужно небольшому DeepSeek
- Почему контекст и свободная память важнее одной цифры RAM
- Ollama, LM Studio и llama.cpp
- Первый запуск на CPU через llama.cpp из архива
- Что получилось на Linux-машине
- Ответы на три небольшие задачи
- Как запустить DeepSeek через Ollama или LM Studio
- Можно ли пользоваться DeepSeek без интернета
- Что проверить, если модель не запускается или отвечает плохо
- С чего начать
DeepSeek можно запустить на компьютере без постоянного обращения к облачному чату. Для первого знакомства подойдёт небольшая модель R1-distill, а для полной современной DeepSeek V4.1 понадобится серверное железо: её официальный набор файлов занимает около 510 ГБ. Разбираем, какую модель выбрать, сколько памяти заложить и как устроен первый запуск на CPU.
Что означает локальный запуск DeepSeek
При локальном запуске программа загружает файл модели с диска и вычисляет ответ на процессоре или видеокарте вашего компьютера. Основные компоненты — сама модель, программа для её запуска и интерфейс, в котором вы задаёте вопросы. Веса модели — это сохранённые числовые значения, на которых основана её работа. Их объём во многом определяет требования к памяти.
Под названием DeepSeek доступны разные вещи: веб-чат, открытые модели и приложения для работы с ними. Например, DeepSeek Harness предоставляет агенту инструменты и доступ к рабочим файлам. Установка такого приложения сама по себе не переносит подключённую облачную модель на ваш компьютер.
Поэтому перед скачиванием важны три вопроса: какая именно модель выбрана, откуда загружаются её веса и где выполняются вычисления. Одна команда в локальном терминале может запустить как скачанную модель, так и обращение к серверу провайдера.
Полные модели DeepSeek и требования к серверу
Актуальная полная модель DeepSeek-V4.1-Flash вышла 10 сентября 2026 года. Она принимает текст и изображения. У неё 552 млрд параметров основной сети и ещё 196 млрд параметров условной памяти Engram. На обработке входных данных активируются 8 млрд параметров, при генерации ответа — 16 млрд.
Слово Flash и небольшое число активных параметров описывают эффективность вычислений. Они не превращают полную модель в файл на 8 или 16 ГБ. DeepSeek использует архитектуру со множеством экспертов: для очередного фрагмента текста выбирается только часть сети, но остальные веса тоже нужно хранить и получать к ним доступ.
В официальном репозитории V4.1-Flash опубликовано около 510 ГБ файлов. Инструкция DeepSeek показывает конверсию весов и распределение вычислений между восемью процессами. Это ориентир для серверного развёртывания, а не готовая инструкция для ноутбука с 16 ГБ памяти.
Среди полных моделей встречаются и другие поколения:
| Модель | Масштаб | Пример доступного локального пакета |
|---|---|---|
| DeepSeek-V4.1-Flash | 552B основная сеть + 196B Engram | Официальный репозиторий около 510 ГБ; отдельный серверный запуск |
| DeepSeek-V4-Flash-0731 | 284B основная сеть, 13B активных параметров | В каталоге LM Studio загрузка от 156,40 ГБ |
| DeepSeek-V4-Pro-0813 | 1,6 трлн параметров основной сети, 49B активных | Открытые веса для серверного развёртывания |
| DeepSeek-R1-0528 | 671B основных параметров, 37B активных | В Ollama пакет Q4_K_M около 404 ГБ |
Характеристики V4 приведены в описании семейства, а обновления — в карточках Flash и Pro; размер R1 — в реестре Ollama. Для самого маленького скачиваемого V4-Flash LM Studio указывает как минимум 156 ГБ RAM. Системе и рабочим буферам также нужна память.
Объём пакета зависит от формата и точности весов. Сравнивать 510 ГБ официального репозитория V4.1 и 156 ГБ одного GGUF-пакета V4-Flash как одинаковые варианты хранения нельзя. Эти числа помогают сразу отделить серверные модели от подходящих для обычного компьютера.
Небольшие R1-distill и квантизация
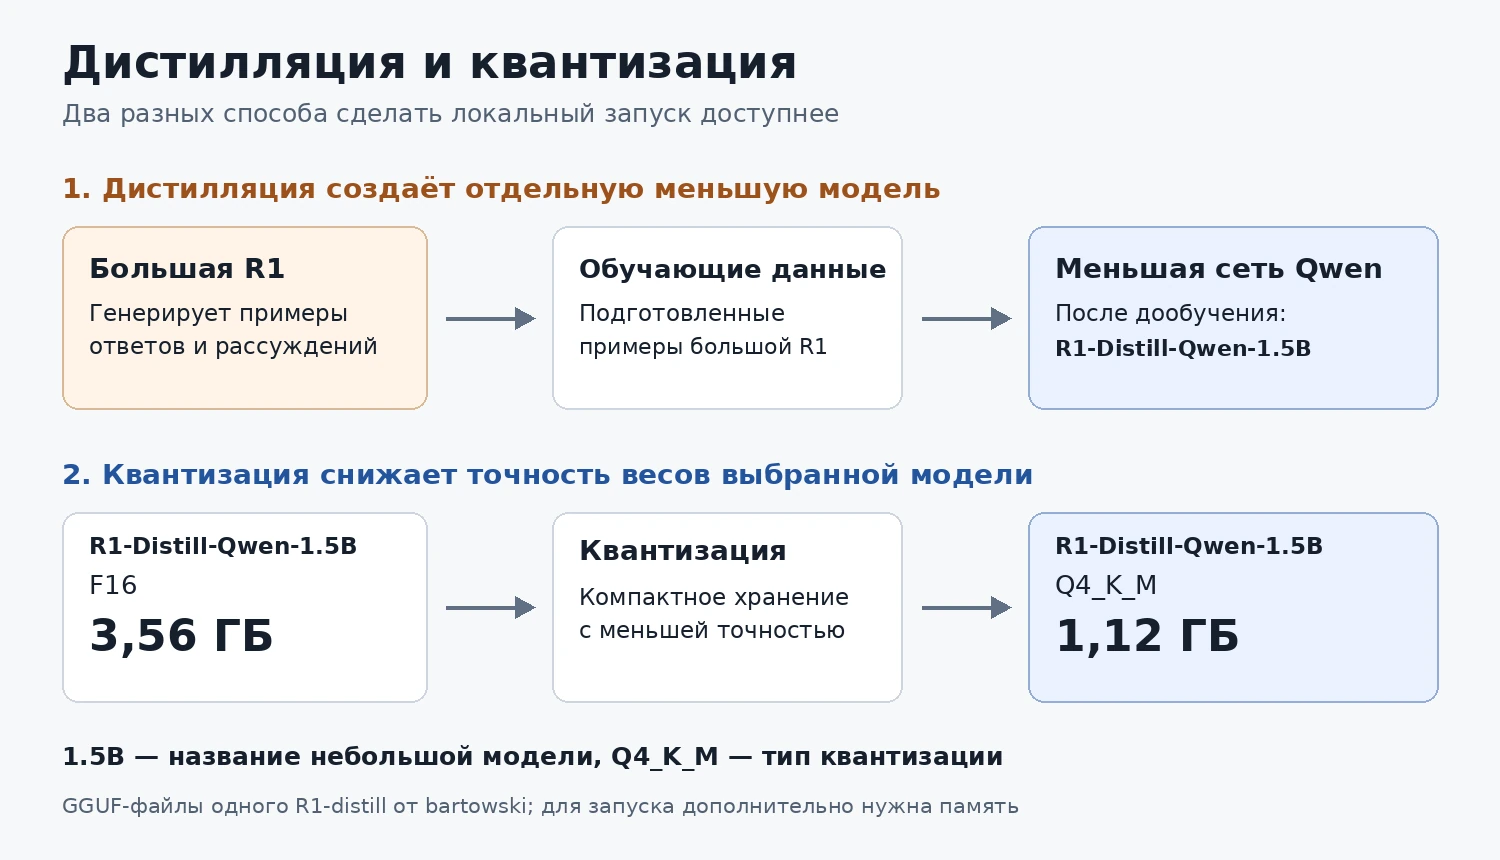
Для домашнего запуска полезнее смотреть на DeepSeek-R1-Distill. Это отдельные небольшие модели на базе Qwen и Llama, дообученные на примерах рассуждений большой R1. В семействе есть варианты от 1.5B до 70B; буква B означает миллиард параметров. Также доступна более поздняя DeepSeek-R1-0528-Qwen3-8B.
Дистилляция меняет саму модель: небольшая сеть учится на подготовленных примерах большой. При этом она не получает все возможности учителя. Модель 1.5B удобна, чтобы проверить загрузку и генерацию текста на скромном железе; её ответы не следует приравнивать к современному веб-чату DeepSeek.
Квантизация решает другую задачу: снижает точность хранения весов уже выбранной модели. Например, для одного R1-Distill-Qwen-1.5B пакет сообщества bartowski занимает около 3,56 ГБ в F16 и 1,12 ГБ в Q4_K_M. Во втором случае скачивается компактная версия этой же небольшой сети. Полная R1 на 671B не превращается таким способом в модель 1.5B.
GGUF — формат файла для запуска модели, который используют llama.cpp и совместимые приложения. Обозначение Q4_K_M относится к смешанной квантизации примерно четырёхбитного класса. В файле хранятся дополнительные коэффициенты и метаданные, а часть весов имеет другую точность, поэтому простой расчёт «параметры × четыре бита» не даёт точного размера.
Для первого запуска Q4_K_M позволяет сократить загрузку и расход памяти. Более высокая точность, например Q8_0, занимает больше места. Выбор квантизации влияет и на ответы модели, и на работу конкретного вычислительного движка.
Сколько RAM и видеопамяти нужно небольшому DeepSeek
В таблице — небольшие варианты, доступные в Ollama, и размеры их пакетов Q4_K_M. RAM — обычная оперативная память; VRAM — собственная память дискретной видеокарты. Для начала берём один диалог и небольшой контекст на 2–4 тысячи токенов.
| Модель | Загрузка Q4_K_M | RAM компьютера для первого выбора | VRAM для размещения модели на GPU |
|---|---|---|---|
| R1-Distill-Qwen-1.5B | 1,1 ГБ | 8 ГБ | 4 ГБ |
| R1-Distill-Qwen-7B | 4,7 ГБ | 16 ГБ | 8 ГБ |
| R1-0528-Qwen3-8B | 5,2 ГБ | 16 ГБ | 8–12 ГБ |
| R1-Distill-Qwen-14B | 9 ГБ | 32 ГБ | 16 ГБ |
| R1-Distill-Qwen-32B | 20 ГБ | 64 ГБ | 32 ГБ |
| R1-Distill-Llama-70B | 43 ГБ | 128 ГБ | 64 ГБ |
Столбцы памяти — удобные стартовые конфигурации с запасом для короткого диалога. CPU использует системную RAM; при полном переносе на видеокарту веса и рабочие данные должны поместиться в VRAM. Значения не нужно складывать как обязательный минимум: это два разных маршрута запуска. При смешанном размещении часть работы остаётся на CPU, часть переходит на GPU.
Размер загрузки показывает место на диске. Во время работы дополнительно нужны память для контекста, промежуточные буферы и ресурсы самой программы. Поэтому файл на 9 ГБ не означает, что компьютеру хватит ровно 9 ГБ RAM. В LM Studio перед загрузкой можно получить оценку памяти для выбранного контекста.
На Mac с Apple silicon CPU и GPU используют общую память. Её нельзя считать как отдельные складываемые объёмы RAM и VRAM. Например, Mac с 16 ГБ общей памяти и PC с 16 ГБ RAM плюс видеокартой на 8 ГБ имеют разные возможности размещения модели.
Практический выбор прост: 1.5B — для проверки на слабом компьютере, 7B или 8B — следующий шаг при 16 ГБ RAM, 14B — при большем запасе памяти. Сначала стоит убедиться, что модель отвечает на ваших коротких задачах, а затем увеличивать её размер.
Почему контекст и свободная память важнее одной цифры RAM
Контекст — текст, к которому модель может обращаться в текущем диалоге: сообщения, инструкции, приложенные фрагменты и создаваемый ответ. Он измеряется токенами, то есть небольшими частями текста. По мере обработки диалога программа хранит промежуточные данные внимания, или KV-кэш.
Большой контекст увеличивает расход памяти. Указанные на карточке модели 128K или 1M токенов — её возможности, а не обещание работы с такой длиной на любом компьютере. Для знакомства достаточно установить 2048 или 4096 токенов и попросить короткий ответ. Документация Ollama отдельно связывает размер контекста с требуемой памятью.
Перед запуском посмотрите свободную RAM, а не только установленную. Браузер с десятками вкладок, видеоредактор или игра могут занимать значительную часть памяти. Несколько одновременных диалогов тоже увеличивают нагрузку. Если система начинает активно использовать диск вместо RAM, ответ может замедлиться настолько, что работа станет неудобной.
Для GPU важны объём VRAM, поддерживаемый программой вычислительный движок и драйвер. Название дорогой видеокарты само по себе не отвечает на вопрос, поместится ли модель. Для CPU имеют значение поддерживаемые инструкции, скорость памяти и число выделенных потоков. Увеличение числа потоков до максимума не всегда делает генерацию быстрее.
Ollama, LM Studio и llama.cpp
Выбирать программу лучше по тому, как вы собираетесь работать.
- Ollama удобна для запуска модели по имени из каталога и подключения к локальному API. Команды скрывают большую часть работы с файлами и шаблоном диалога.
- LM Studio подходит, если нужен графический интерфейс: поиск модели, выбор файла и общение в одном приложении. Для Windows x64 требуется AVX2; на Mac поддерживается Apple silicon, Intel Mac в список не входит.
- llama.cpp даёт прямой контроль над GGUF-файлом, контекстом, потоками CPU и переносом слоёв на GPU. У проекта есть готовые сборки для разных ОС, поэтому для простого маршрута не обязательно собирать программу из исходников или устанавливать Python.
В одном каталоге могут соседствовать локальные и облачные варианты. Например, deepseek-v4.1-flash:cloud в Ollama обращается к модели у провайдера. Веса V4.1 не загружаются на PC, а промпт отправляется через интернет. Ollama Cloud прямо описывает такой способ работы.
В llama.cpp поддержка V4.1 ещё оформляется отдельным изменением. Наличие открытых весов или стороннего GGUF-файла не означает, что любая установленная версия программы сможет правильно работать с архитектурой модели. Для первого запуска проще выбрать давно поддерживаемый небольшой R1-distill.
Первый запуск на CPU через llama.cpp из архива
Для небольшого воспроизводимого примера возьмём DeepSeek-R1-Distill-Qwen-1.5B в Q4_K_M. Он демонстрирует локальную загрузку и генерацию без дискретной видеокарты. Исходная модель опубликована DeepSeek, а готовый GGUF-файл подготовил bartowski. Это сборка сообщества, а не официальный GGUF от DeepSeek.
Порядок действий:
- На странице релизов llama.cpp выберите архив для своей ОС и архитектуры. Для CPU-маршрута Windows x64 и Linux x64 нужны соответствующие CPU-сборки; CUDA-сборка относится к другому маршруту.
- Распакуйте архив в отдельную папку. Сохраните номер сборки: он понадобится, если поведение программы изменится после обновления.
- Скачайте только файл DeepSeek-R1-Distill-Qwen-1.5B-Q4_K_M.gguf, а не весь репозиторий со всеми вариантами точности. Размер этого файла — 1,117 ГБ.
- Поместите его в подпапку models и начните с контекста 2048, четырёх потоков CPU и одного короткого запроса.
Создайте рядом с программой файл prompt.txt в UTF-8 с содержимым:
<|User|>Магазин продал товар за 1200 рублей после скидки 20%. Какова цена до скидки? Объясни решение по-русски, рассуждай пошагово и помести окончательный ответ в \boxed{}. Не используй внешние данные<|Assistant|><think>После <think> оставьте перевод строки. Служебные метки обозначают сообщение пользователя и начало ответа. Этот вариант использует обычный режим дополнения текста, поэтому метки задаются прямо в файле.
Из распакованной папки выполните в терминале Linux:
./llama-completion --offline \
  -m models/DeepSeek-R1-Distill-Qwen-1.5B-Q4_K_M.gguf \
  -no-cnv -f prompt.txt -c 2048 -n 512 \
  -t 4 -tb 4 -ngl 0 -b 128 -ub 128 \
  --temp 0.6 --top-p 0.95 --top-k 0 --seed 42 \
  --no-display-prompt --simple-io --color off --no-escape
Параметр -ngl 0 оставляет вычисления на CPU, -c 2048 задаёт контекст, а -n 512 ограничивает генерацию 512 токенами. Четыре потока заданы для вычисления ответа и обработки входного текста. В сборке b11476 этот режим запускается через llama-completion.
Что получилось на Linux-машине
8 октября 2026 года мы запустили этот GGUF в llama.cpp b11476 на облачной машине с Debian 13.6 и процессором AMD EPYC 9V74. Среде были доступны девять виртуальных CPU и 9,7 ГиБ RAM, для генерации использовали четыре потока, GPU не подключали. Ответ вычислялся внутри этой Linux-машины. Это запуск модели на собственном runtime, без обращения к API DeepSeek.
Установили контекст 2048 токенов, лимит генерации 512, temperature 0,6, top-p 0,95 и seed 42. Три задачи запускали по два раза в отдельных процессах. Текст в повторах совпал; время выполнения немного различалось.
| Измерение | Результат |
|---|---|
| Время запуска до завершения вывода или лимита 512 токенов, включая загрузку | 16,44–19,16 секунды |
| Первый видимый текст в терминале | Через 1,62–2,20 секунды |
| Пиковая память процесса | До 1,877 ГБ, около 1,75 ГиБ |
| Скорость генерации по таймеру runtime | 29,75–35,74 токена/с |
Первым текстом были промежуточные рассуждения. На арифметике и суммаризации процесс завершился после ответа, а на задаче с кодом время измерено до ограничения в 512 токенов. Пик памяти относится к одному процессу модели; операционной системе и остальным приложениям также нужна RAM.
Отдельный llama-bench в трёх повторах показал 142,28 ± 26,73 токена/с на обработке 128 входных токенов и 39,91 ± 2,98 токена/с на генерации 128 токенов. Здесь измеряются вычисления без разбиения исходного текста на токены и выбора следующего токена. Полный запуск также включает загрузку файла, подготовку запроса и вывод ответа.
Ответы на три небольшие задачи
Цена до скидки. Модель правильно получила 1500 рублей для товара, проданного за 1200 рублей после скидки 20%. В ответе встречались «Скачка» вместо скидки, английские originally и dividing, а также испанское Equación. Итоговая арифметика была верной, русский текст требовал правки.
Три пункта по заданному тексту. Мы передали описание 30-дневного пилота чат-бота, 12 сотрудников и бюджета 60 000 рублей. Модель выдала три номера, но финальный текст преимущественно на английском, повторила бюджет и исказила условие «без передачи человеку» в «without forwarding information to the user».
Функция Python с сохранением порядка. На запрос unique_in_order(items) для списка [3, 1, 3, 2, 1] модель не выдала законченный ответ до лимита 512 токенов. Генерация оборвалась во время рассуждений; промежуточный алгоритм также не решал поставленную задачу.
Все шесть запусков завершились без ошибок программы и без исчерпания памяти. Небольшая модель поместилась в среду и генерировала текст с приемлемой для эксперимента скоростью, но качество русского языка и выполнение инструкций оказались слабым местом. Для этой конфигурации 1.5B удобна как знакомство с механизмом запуска; перед реальной работой полезно выбрать модель по собственным задачам и проверить её ответы.
Для этого маршрута отдельный веб-сервер и доступ из локальной сети не нужны. Ответ появляется в терминале. Если позже понадобится чат в браузере или локальный API, у llama.cpp есть llama-server; запускать его стоит только с выбранными параметрами и доступом через localhost.
Как запустить DeepSeek через Ollama или LM Studio
Если важнее удобство, чем управление каждым файлом, можно начать с Ollama. Для Windows программа работает как обычное приложение на Windows 10 22H2 и новее. Скачивать её стоит с официального сайта.
После установки в терминале выполняется команда для небольшого варианта:
ollama run deepseek-r1:1.5b-qwen-distill-q4_K_MДля следующего шага на компьютере с достаточным запасом памяти:
ollama run deepseek-r1:8b-0528-qwen3-q4_K_MПервая загрузка требует интернета. Затем Ollama использует сохранённые веса. Полный тег указывает поколение, размер и точность. Короткая команда ollama run deepseek-r1 сейчас выбирает 8B-вариант на базе Qwen3, а не полную R1 на 671B. Старый Llama-8B-distill находится под отдельным тегом.
После запуска команда ollama ps показывает загруженные модели и распределение CPU/GPU. В диалоге через командную строку можно задать небольшой контекст:
/set parameter num_ctx 2048В LM Studio найдите полное название модели, выберите локальный скачиваемый GGUF-вариант и проверьте объём файла до загрузки. Затем откройте чат, загрузите модель и установите короткий контекст. Если на карточке предлагается Cloud, вычисления будут выполняться на стороне сервиса. Облачная запись V4.1 не заменяет локальный GGUF.
Можно ли пользоваться DeepSeek без интернета
Да: после скачивания runtime и весов локальная модель может генерировать ответы без соединения с провайдером. Например, LM Studio описывает офлайн-работу для скачанных моделей. При этом загрузка новых весов, получение обновлений и интернет-поиск требуют сети.
Для автономного режима в Ollama отключите облачные возможности с помощью OLLAMA_NO_CLOUD=1 и перезапустите программу. Убедитесь, что выбран скачиваемый тег без cloud. Для проверки можно отключить интернет уже после загрузки и задать простой вопрос на основе текста, который вы сами передали модели.
Приватность зависит от всего маршрута. Подключённый поиск, внешние инструменты и агентные плагины могут отправлять информацию отдельным сервисам, даже когда сама модель работает на CPU рядом с вами. История диалога и журналы программы могут сохраняться на диске. Для первых проб используйте небольшой вымышленный текст, а доступ сервера оставляйте на 127.0.0.1.
Лицензию тоже нужно смотреть у конкретной версии. V4.1 и R1 опубликованы под MIT; у R1-distill на базе Qwen и Llama есть указанные в официальном репозитории исходные семейства и их лицензии. У открытых весов, стороннего приложения и облачного сервиса разные условия использования. Бесплатная загрузка модели не оплачивает сервер, электричество или услуги провайдера.
Что проверить, если модель не запускается или отвечает плохо
Не хватает памяти. Выберите меньшую модель, начните с Q4_K_M, сократите контекст и закройте тяжёлые приложения. Файл нужного размера на SSD ещё не означает, что для его работы достаточно RAM или VRAM.
Программа не распознаёт модель. Сверьте архитектуру и поддержку своей версии runtime. Файл GGUF не является универсальной гарантией совместимости со всеми приложениями. Для новой V4.1 это особенно важно.
Ответ слишком долго не заканчивается. Reasoning-модель может тратить большую часть генерации на промежуточные рассуждения. Уменьшите задачу и посмотрите, достигает ли она итогового ответа до установленного лимита. Оборванный текст и завершённое решение — разные результаты.
Модель смешивает языки или выдумывает факты. Дайте короткий русский запрос и небольшой исходный текст. Проверьте результат на задаче с известным ответом. Подключение локальной модели не устраняет ошибки, а уменьшение сети и точности не гарантирует качество флагмана.
При выключенном интернете всё перестало работать. Проверьте выбранный тег, облачные настройки и внешние инструменты. Возможно, установленное на компьютере приложение только обращается к удалённой модели.
С чего начать
Если вы хотите понять сам принцип, начните с R1-Distill-Qwen-1.5B Q4_K_M, короткого контекста и одного запроса. При 16 ГБ RAM можно переходить к 7B или R1-0528-Qwen3-8B и сравнивать ответы на своих задачах. Для работы с длинными текстами и более крупными моделями сначала оцените доступную память и поддержку runtime.
Полная DeepSeek-V4.1-Flash относится к серверному классу. Когда важны возможности современной модели, а контроль над локальным вычислением не нужен, проще использовать сервис. Когда важны автономность, работа с небольшими собственными текстами и управление средой, локальный R1-distill даёт понятный старт.