- Что понадобится для русской озвучки
- Какую модель и голос выбрать
- Подготовим текст аудиогида
- Как получить первую запись в Text to Speech
- Что слушать при сравнении двух версий
- Что получилось в нашем примере
- Как исправить ударение и трудное слово
- Когда нужен словарь произношения
- Как управлять паузами без лишних эффектов
- Как скачать озвучку и посчитать расход
- Можно ли использовать запись на сайте или в рекламе
- Как понять, что озвучка готова
В озвучке легко пропустить ошибку, если голос звучит убедительно. Дата может превратиться в набор чисел, фамилия получить неверное ударение, а короткая пауза исчезнуть между двумя важными фразами. В ElevenLabs такие места удобнее исправлять на коротком фрагменте: подготовить текст, выбрать голос, получить запись и исправлять проблемные места по одному. Разберём этот порядок на вымышленном аудиогиде музея «Лума».
Что понадобится для русской озвучки
ElevenLabs создаёт речь по написанному тексту. Для этого используется Text to Speech, сокращённо TTS. У сервиса есть и другие инструменты, но для короткого объявления не нужны дубляж видео, голосовой агент или клонирование. Достаточно своего сценария и готового голоса.
Сначала проверьте доступ. ElevenLabs прямо включает Россию в перечень стран с блокировкой подключений. Поддержка русского языка относится к озвучке и не снимает это ограничение. Следующие шаги рассчитаны на пользователей, которым официальный сервис доступен по его условиям.
Подготовьте небольшой самостоятельный отрывок и определите, где он будет звучать: в учебном ролике, аудиогиде, личном проекте или рекламе. От этого зависят темп, подача и требования к лицензии. Если запись предназначена для клиента или коммерческого сайта, право на такое использование нужно выяснить до генерации.
Храните рядом две версии сценария. Первая — обычный текст для чтения глазами. Вторая — текст для диктора: в нём можно раскрыть сокращения, записать цифры словами и перестроить тяжёлые предложения. Исправления произношения не должны незаметно менять дату события, стоимость билета или смысл объявления.
Какую модель и голос выбрать
Голос и модель выполняют разные роли. Голос задаёт узнаваемое звучание, а модель синтезирует речь и определяет доступные способы управления. Смена одного параметра не заменяет проверку другого.
Для выразительного рассказа можно начать с Eleven v4. В каталоге моделей русский указан среди поддерживаемых языков v4, v3, Multilingual v2 и Flash v2.5. Flash v2 без «.5» предназначена для английского. Для длинного спокойного повествования уместно отдельно сравнить короткий фрагмент с Multilingual v2; выбирать победителя по названию или одному рекламному примеру не стоит.
В v4 используются настройки Stability (стабильность подачи) и Similarity (сходство с выбранным голосом). Ползунков Style и Speed у неё нет — это указано в справке по v4. Поэтому инструкция для старой модели, предлагающая установить скорость и стиль в определённые значения, может не соответствовать вашему экрану. Возможности v4 и v4 Turbo подробно разобраны в отдельной новости о релизе.
Для музейного объявления ищите готовый голос с ясной дикцией и спокойной подачей. Прослушайте несколько образцов, затем проверьте выбранный голос на собственном русском предложении. Красивый английский образец мало говорит о том, как прозвучит русская фамилия или сумма в рублях. Проверьте доступность выбранного голоса на вашем тарифе и его кредитный множитель: некоторые голоса в Voice Library обходятся дороже стандартных.
В первой попытке оставьте доступные настройки близкими к исходным и запишите их значения. Если одновременно поменять голос, модель, текст и параметры, будет трудно понять, откуда появилась разница. Для короткого учебного фрагмента полезнее один понятный выбор, чем десяток случайных комбинаций.
Подготовим текст аудиогида
Возьмём вымышленное объявление. В нём есть несколько мест, которые стоит проверять отдельно:
«12.10.2026 музей “Лума” открыт с 10:30. Билет стоит 1 490 ₽. За рекой стоит старый замок. На двери установлен новый замок. Вопросы можно задать AI-помощнику».
Здесь дата должна прозвучать как дата, время — как время открытия, а сумма — в рублях. В двух предложениях одинаково написанное слово «замок» обозначает разные вещи. В придуманном названии «Лума» поставим ударение на первый слог. Сокращение AI можно прочитать буквами или заменить русским выражением — нужный вариант решает автор сценария.
Для второй версии раскроем числа и сокращение, сохранив факты и оба омографа:
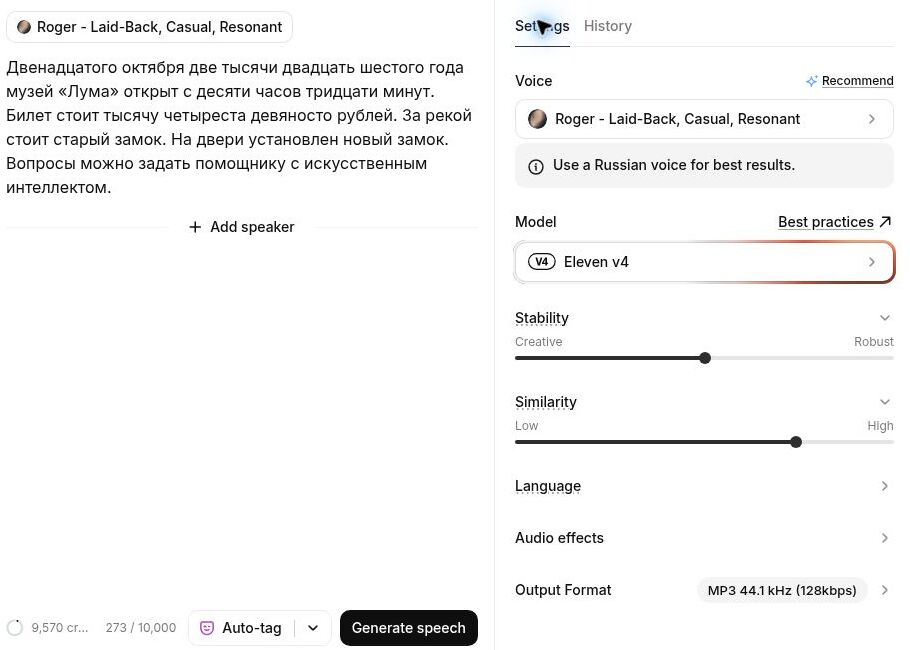
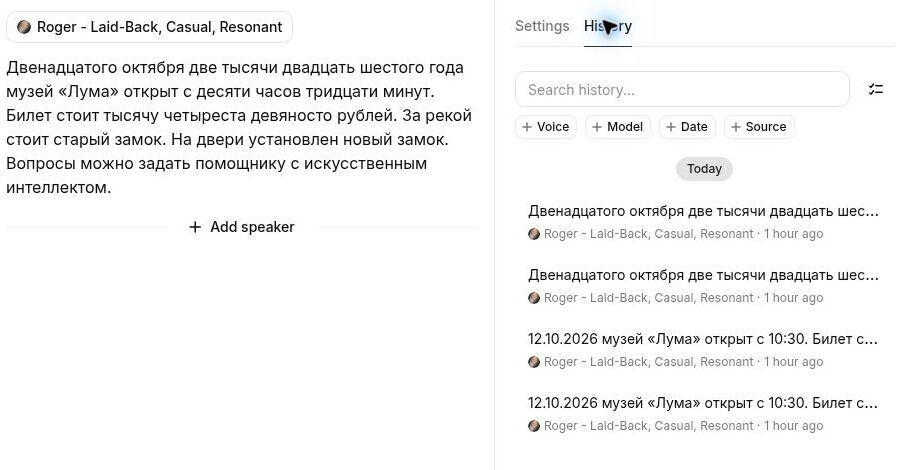
«Двенадцатого октября две тысячи двадцать шестого года музей “Лума” открыт с десяти часов тридцати минут. Билет стоит тысячу четыреста девяносто рублей. За рекой стоит старый замок. На двери установлен новый замок. Вопросы можно задать помощнику с искусственным интеллектом».
Веб-версия сама нормализует числа, но запись словами помогает явно задать нужное чтение даты, времени и цены. Числа словами особенно полезны там, где неоднозначное чтение меняет смысл: номер экспоната, десятичная дробь, телефон, диапазон лет. Не превращайте всё в механическую замену. Например, номер «104» в телефонной справке и «104 рубля» требуют разного произнесения.
Проверьте падежи после раскрытия цифр. «Билет стоит тысячу четыреста девяносто рублей» и «стоимость билета — тысяча четыреста девяносто рублей» отличаются грамматически. Если подготовку поручаете чат-боту, попросите сохранить все значения и отдельно покажите ему желаемый способ чтения номеров. После этого сравните результат с исходником.
Как получить первую запись в Text to Speech
В официальном интерфейсе откройте Text to Speech, вставьте первую версию сценария, выберите модель и готовый голос. Затем запустите Generate speech и дождитесь аудио. Базовый маршрут описан в руководстве ElevenLabs.
В поле озвучки помещайте то, что должно прозвучать. Фраза «прочитай этот текст красиво» внутри сценария может стать частью записи. Для первого прохода не добавляйте эмоциональных тегов: спокойное объявление позволяет легче заметить ошибки в словах.
Сохраните исходный результат до правок. Дайте файлу понятное имя, например «Лума — исходный текст». Рядом запишите модель, выбранный голос, настройки и текст именно этой попытки. Не перезаписывайте этот файл следующим дублем: иначе сравнивать будет не с чем.
Получите вторую запись с раскрытыми датой, временем, суммой и AI. Голос и модель оставьте прежними. Скачайте результат отдельно как «Лума — числа словами».
Повторная генерация может отличаться по интонации даже при одинаковых настройках. Оценивайте конкретную запись целиком: удачно прочитанная цена не компенсирует пропавшее слово в следующем предложении.
Что слушать при сравнении двух версий
Сначала прослушайте каждую запись полностью, без текста перед глазами. Понятно ли, когда музей открыт, сколько стоит билет и куда обращаться с вопросом? Затем включите её ещё раз со сценарием и остановитесь на контрольных местах.
- Дата: слышны двенадцатое октября и две тысячи двадцать шестой год, без потери или перестановки цифр
- Время: музей открывается в десять тридцать, а не работает десять часов тридцать минут
- Цена: тысяча четыреста девяносто рублей; сумма и валюта не изменились
- Название: «Лума» произносится с задуманным ударением на первом слоге
- Омографы: за рекой находится за́мок, а на двери — замо́к
- Сокращение: AI читается выбранным способом либо заменено выражением «искусственный интеллект»
В отдельной заметке достаточно четырёх полей: фрагмент, как должен звучать, что слышно в записи, следующая правка. Например, если в фразе о двери слышен «за́мок», зафиксируйте именно эту ошибку. Не пишите просто «плохая дикция»: такая запись не подсказывает, что менять.
Автоматическая расшифровка может помочь найти пропуск слова или неправильную сумму. Но одинаково написанные «за́мок» и «замо́к» в расшифровке обычно выглядят одинаково. По одному текстовому выводу нельзя удостовериться, что ударение исправлено. Проверяйте сам звук, а для важного имени попросите носителя нужного произношения подтвердить результат.
Если первая версия прочитана верно, сохраните её. Сравните темп и удобство восприятия, выберите подходящую запись и сохраните причину выбора.
Что получилось в нашем примере
Для сравнения сгенерировали обе версии аудиогида в Eleven v4 с готовым голосом Roger — Laid-Back, Casual, Resonant. Настройки оставили одинаковыми: Stability 0,5 и Similarity 0,75. Для каждой версии сохранили первый из двух предложенных дублей в MP3 44,1 кГц, 128 кбит/с.
При ручной слуховой проверке обеих записей ошибок не обнаружили: слова и ударения прозвучали правильно. Заметной разницы между чтением чисел, записанных цифрами и словами, также не нашли. Поэтому третий вариант с исправлениями не понадобился.
Это результат одного короткого сценария с конкретным голосом и моделью. Он показывает, что раскрывать каждое число словами заранее необязательно: сначала стоит послушать исходный вариант. Если в вашей записи есть ошибка, меняйте соответствующий фрагмент и сравнивайте результат. Следующие приёмы пригодятся именно для таких случаев.
Как исправить ударение и трудное слово
Начинайте с конкретного проблемного предложения. Не переписывайте весь аудиогид и не меняйте модель после каждой ошибки. Сначала попробуйте уточнить контекст, сохранив смысл: «На двери установлен новый дверной замок» или «За рекой находится здание старого замка». Дополнительное слово помогает однозначно задать предмет разговора.
Если точная формулировка не обязательна, можно убрать омограф: «За рекой стоит старинная крепость». Это редакторское решение, а не фонетическая настройка. Используйте его только там, где замена действительно подходит по смыслу. В названии экспоната, фамилии человека или официальном термине такая свобода может быть недопустима.
Заглавная гласная или разделение дефисами иногда используются как подсказки. Не добавляйте их сразу ко всему тексту. Проверьте одну изменённую фразу: необычное написание способно повлиять на ритм или само стать причиной неверного чтения. Рабочий приём для одного голоса и модели не следует считать универсальной командой ElevenLabs.
Для v4 есть ещё один способ — IPA, международный фонетический алфавит. Модель понимает фонетическую запись между косыми чертами. Здесь важны точные символы и место ударения, поэтому транскрипцию имени или термина лучше брать из надёжного словаря либо уточнять у специалиста. Применяйте её только к проблемному слову и проверяйте в полном предложении. Рекомендации ElevenLabs по произношению отдельно предупреждают, что результат зависит от голоса и фразы.
После правки получите третью запись и сравните её со второй. Включайте не только изменённое слово, но и соседние предложения: вставка должна подходить по темпу, громкости и интонации. Если ошибка исчезла, а начало фразы стало обрывистым, работу рано считать законченной.
Когда нужен словарь произношения
Если одно название встречается много раз, удобнее один раз задать правило, чем вручную менять каждый фрагмент. Для этого в ElevenLabs используются словари произношения. Правило alias подставляет вместо написанного слова другой вариант чтения. Например, для нашего сценария можно связать «AI-помощнику» с выражением «помощнику с искусственным интеллектом».
Учитывайте область действия правила. Нельзя задать всем вхождениям слова «замок» одно произношение, когда в тексте есть и здание, и дверной механизм. Для таких случаев безопаснее править конкретное предложение. Указывайте точную форму слова: правило для «AI-помощнику» не следует считать заменой для всех падежей. Правила словаря чувствительны и к регистру.
В актуальном руководстве по словарям фонемные правила для неанглийского текста связаны с v4. Это руководство относится к API, программному интерфейсу сервиса. В справке редактора Studio для фонем перечислены другие модели — Flash v2 и Turbo v2; поддержку русских фонем из API нельзя автоматически переносить в Studio.
Если работаете в Studio, откройте редактор произношения проекта и проверьте доступные типы правил. Справка Pronunciations Editor описывает добавление замены и предварительное прослушивание. Для короткого аудиогида из нескольких предложений обычно проще сначала отредактировать сам текст; словарь оправдан, когда термин повторяется в большой серии записей.
Как управлять паузами без лишних эффектов
В аудиогиде пауза помогает отделить режим работы от цены, а описание экспоната — от инструкции посетителю. Начните с обычных предложений и абзацев. Не ставьте многоточие после каждой фразы: спокойное объяснение может превратиться в нарочито задумчивую речь.
В Eleven v4 и v3 не работают SSML-теги break. Инструкцию с конструкцией <break time="1.5s" /> нельзя автоматически переносить на эти модели. В v4 для подачи используются пунктуация, структура текста и аудиотеги. Например, [whispers] относится к шёпоту, а [laughs] — к смеху. Для сообщения о билетах они обычно не нужны.
Если после цены требуется ровно определённый промежуток тишины для видеомонтажа, точнее выставить его в аудио- или видеоредакторе. Генерация интонации и монтаж по времени решают разные задачи. Не перегружайте сценарий тегами ради точного попадания в таймлайн.
Для длинной записи разделяйте материал по смыслу: вступление, отдельный экспонат, переход, завершение. В каждом фрагменте оставляйте достаточно контекста для имени и омографов. После сборки прослушайте стыки: резкая смена тембра или повтор последнего слова заметнее, чем небольшая разница между настройками.
Как скачать озвучку и посчитать расход
После генерации можно скачать результат кнопкой загрузки. Предыдущие записи доступны в History. В истории ElevenLabs предлагает MP3 и WAV, а дополнительные форматы находятся в Advanced. Выбирайте формат, доступный вашему аккаунту и подходящий для монтажа; название WAV само по себе не гарантирует более качественное исходное звучание.
Для передачи редактору приложите не только аудио, но и соответствующий текст. Понятные названия «исходник», «числа словами», «правка названия» помогают избежать ситуации, когда в ролик попадает старый дубль. Финальную запись прослушайте уже после скачивания и монтажа.
На странице тарифов Free включает 10 000 кредитов в месяц, Starter — 30 000, Creator — 121 000. Обычная помесячная цена Starter указана как 6 долларов, Creator — 22 доллара; предложения для первого месяца показаны отдельно, налоги не включены. Для выбора плана важнее нужные права и объём работы, чем рекламная цена первого платежа.
Кредиты расходуются на генерацию, а не на повторное скачивание того же файла. Расход зависит от модели, выбранного голоса и режима генерации. Перед новым дублем смотрите подсказку интерфейса о списании: бесплатная повторная генерация доступна лишь при определённых условиях, а изменение текста может означать новую платную попытку. Короткий проверочный отрывок позволяет сначала подобрать чтение и только потом обрабатывать большой сценарий.
Можно ли использовать запись на сайте или в рекламе
Согласно условиям ElevenLabs, пункт 1(c), на Free разрешено только некоммерческое использование сервиса. Для работы над рекламой, клиентским роликом или материалом коммерческого сайта нужен подходящий платный план ещё до генерации. При разрешённой некоммерческой публикации бесплатного результата ElevenLabs требует указать elevenlabs.io или 11.ai в заголовке.
Важен момент создания записи. По правилам публикации ElevenLabs коммерческое использование относится к материалам, созданным во время платной подписки. Покупка плана позднее не превращает старый бесплатный файл в коммерчески лицензированный. Для Beta Services действуют отдельные ограничения: их результаты нельзя использовать коммерчески и в рабочем продукте.
Готовый голос избавляет от необходимости записывать и клонировать человека, но не отменяет условий сервиса и конкретного голоса. Для учебного примера используйте собственный текст; для чужого произведения или клиентского материала заранее определите, разрешены ли его обработка и распространение.
Как понять, что озвучка готова
Запись готова к дальнейшей работе, когда слушателю понятен смысл, правильно прочитаны числа, имена и слова с неоднозначным ударением. В нашем аудиогиде это дата, время, сумма, название музея, два «замка» и способ чтения AI.
До генерации выберите тариф с нужными правами. Начните с короткого сценария, сохраните первый вариант и меняйте только те места, где действительно есть проблема. Раскройте неоднозначные числа, уточните контекст, при необходимости примените словарь или подходящий для модели фонетический способ. Затем прослушайте запись целиком. Такой порядок даёт гораздо больше контроля, чем бесконечное нажатие Generate в надежде случайно получить идеальный дубль.