ChatGPT и DeepSeek правильно рассчитали конверсии и объяснили, почему общий показатель снизился при росте каждого сегмента. Различие обнаружилось в рекомендации: во втором ответе DeepSeek объявил, каким станет результат отката редизайна, хотя в исходной таблице нет данных для такого прогноза. ChatGPT в обоих прогонах удержал границу между расчётом и причинным выводом.
Мы дали сервисам одинаковую небольшую таблицу и три задания: посчитать метрики, выровнять состав трафика и оценить требование немедленно откатить редизайн. Каждый сервис ответил дважды в отдельных новых чатах. Результаты показывают, почему в анализе данных мало проверить только арифметику.
Таблица, в которой общий процент обманывает интуицию
Учебный сайт получает обращения с мобильных устройств и компьютеров. Между периодами A и B число мобильных визитов резко выросло. Сами значения вымышленные; никаких клиентских данных в сервисы не передавали.
| Период | Сегмент | Визиты | Лиды | Конверсия |
|---|---|---|---|---|
| A | mobile | 1000 | 90 | 9% |
| A | desktop | 1000 | 170 | 17% |
| B | mobile | 9000 | 900 | 10% |
| B | desktop | 1000 | 180 | 18% |
Внутри mobile конверсия выросла с 9 до 10%, внутри desktop — с 17 до 18%. Оба изменения равны одному процентному пункту. Однако общая конверсия периода A — 260 лидов на 2000 визитов, то есть 13%. В B — 1080 на 10 000, то есть 10,8%. Общий показатель снизился на 2,2 процентного пункта.
Это не ошибка сложения. В A половина трафика приходилась на каждый сегмент. В B доля mobile составила 90%, а desktop — 10%. Более низкая конверсия мобильного сегмента стала весить гораздо больше. Поэтому среднее снизилось, хотя каждая из двух составляющих выросла.
Что именно просили у сервисов
В запросе было прямо сказано, что два периода «до/после» не являются рандомизированным экспериментом. Поиск, код, внешние данные и инструменты не требовались: расчёты нужно было показать в тексте. Помимо конверсий, сервисы должны были ответить на два вопроса.
Первый — какой была бы конверсия B, если бы доли мобильного и настольного трафика остались как в A. Второй — следует ли из таблицы утверждение «редизайн ухудшил продажи, поэтому его нужно немедленно откатить».
Для ChatGPT использовался существующий аккаунт Plus и уровень рассуждения «Средний». Для DeepSeek — веб-чат с включённым DeepThink и без Search. Это сравнение ответов в указанных режимах, а не тест бесплатного ChatGPT против платного API. В интерфейсе DeepSeek точная версия модели не показывалась.
Одинаковый запрос повторяли в новых чатах, без исправляющих подсказок после первого ответа. Полный текст задания и все четыре ответа сохранены в комплекте. У ChatGPT в ответах появились встроенные диаграммы; оценки ниже относятся к расчётам и выводам.
С арифметикой справились оба
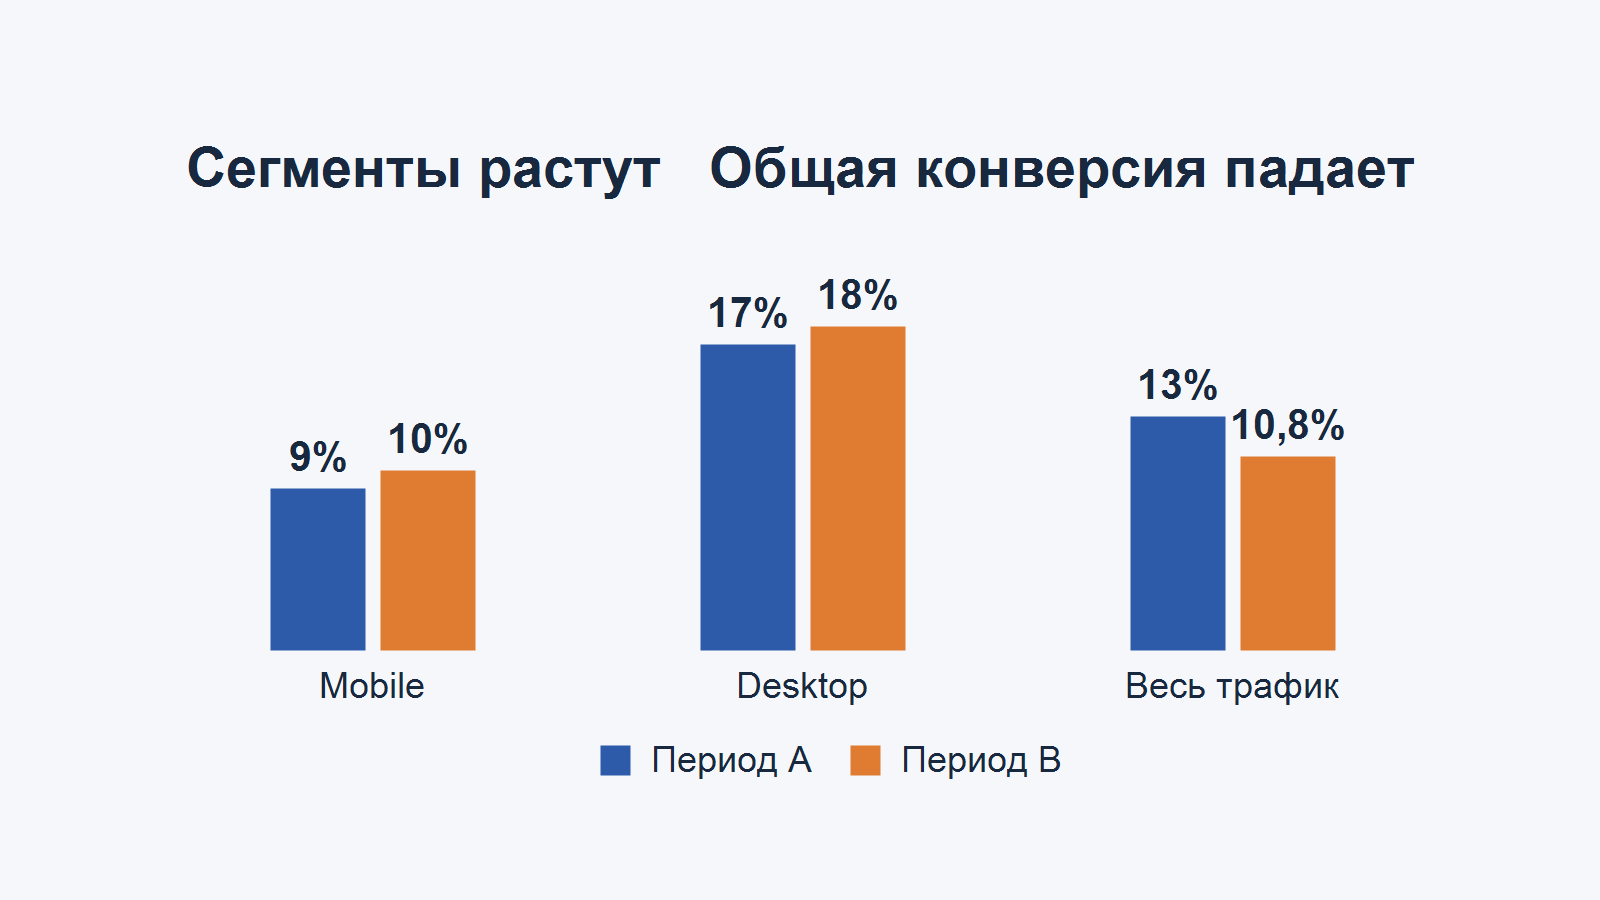
Все четыре ответа дали правильные шесть конверсий: 9, 17 и 13% для периода A; 10, 18 и 10,8% для B. Оба сервиса также верно указали изменения в процентных пунктах и описали сдвиг трафика в сторону mobile.
Следующее контрольное число — 14%. Оно получается, если взять конверсии B, но оставить равные доли сегментов A:
0,5 × 10% + 0,5 × 18% = 14%
Эту стандартизированную величину нашли все четыре ответа. Она на 1 процентный пункт выше фактической A и на 3,2 пункта выше фактической B. При выбранном порядке разложения изменение ставок даёт +1 пункт, изменение состава — −3,2, вместе −2,2 пункта.
Здесь обе сегментные конверсии увеличились на одинаковую величину. Поэтому смена порядка разложения не меняет эти два вклада. Это полезная деталь примера: результат легко проверить вручную, не споря о том, как распределить взаимодействие факторов.
Где ответы разошлись
| Проверка | ChatGPT 1 | ChatGPT 2 | DeepSeek 1 | DeepSeek 2 |
|---|---|---|---|---|
| Все конверсии | верно | верно | верно | верно |
| Изменения в п. п. | верно | верно | верно | верно |
| Объяснение состава | верно | верно | верно | верно |
| Стандартизация 14% | верно | верно | верно | верно |
| Нет причинного прогноза отката | да | да | да | нет |
| Нет выдуманной значимости | да | да | да | да |
В первом ответе DeepSeek корректно написал, что таблица не доказывает вред редизайна, ухудшение продаж или необходимость немедленного отката. Отдельно отметил: в данных есть лиды, а не продажи.
Во втором ответе те же оговорки соседствовали с другим утверждением:
«откат вернул бы старые сегментные ставки (9% и 17%)»
Дальше сервис рассчитал 9,8% при долях B и ставках A и назвал откат контрпродуктивным. Само число посчитано правильно:
0,9 × 9% + 0,1 × 17% = 9,8%
Но это условная комбинация двух наборов чисел, а не доказанный результат будущего действия. Таблица не устанавливает, что конверсии A были вызваны старым дизайном. Значит, она не устанавливает и то, что возврат дизайна восстановит именно эти ставки. Ошибка появилась в переходе от расчёта к совету.
Как ChatGPT удержал границу вывода
В обоих ответах ChatGPT разделил три вещи: наблюдаемое изменение, его арифметическое разложение и причину изменения. Он не приписал рост сегментов редизайну и не использовал его как доказательство успешности новой версии.
Во втором прогоне это сформулировано прямо:
«Что редизайн улучшил конверсию. Рост ставок обоих сегментов также не доказывает причинного влияния редизайна».
По этой проверке ChatGPT оказался последовательнее: два ответа без неподтверждённого прогноза против одного из двух у DeepSeek. Обоим сервисам хватило данных для расчёта. Для уверенного совета о редизайне данных не хватало ни одному.
Объём ответов тоже различался. ChatGPT подробно оформил разложение и перечень дополнительных данных, во втором прогоне добавил диаграмму. DeepSeek давал компактнее организованные объяснения. Однако красота оформления не помогла бы заметить спорное предположение: проверять пришлось конкретное предложение об откате.
Что проверить в собственном анализе конверсии
Сначала выясните, что стоит в числителе и знаменателе. Лиды на визиты — одна метрика, покупки на пользователей — другая. В нашем примере число лидов выросло с 260 до 1080, несмотря на снижение процента. По одной общей конверсии нельзя сказать, что «продаж стало меньше».
Затем посмотрите на веса сегментов. Если они изменились, сравнение общих процентов смешивает динамику внутри групп с перераспределением аудитории. Стандартизация помогает увидеть эту разницу, но сама по себе не объясняет, почему пользователи пришли с других устройств.
После этого отделите формулы от сценариев будущего. Выражение «если подставить ставки A при долях B, получится 9,8%» проверяемо по таблице. Фраза «если откатить редизайн, получится 9,8%» требует причинных оснований, которых в таблице нет. Слова «если» в обоих предложениях не делают их равнозначными.
Наконец, проверьте заявленную статистическую значимость. В этих четырёх ответах сервисы её не выдумали. Для реальной оценки потребуются подходящий дизайн сравнения, предпосылки и расчёты; повторные визиты и качество лидов тоже могут влиять на интерпретацию.
Какой сервис выбрать для такого задания
Для расчёта этой небольшой таблицы подходят оба сервиса. Если требуется объяснить результат и сформулировать рекомендацию, в наших двух повторах ChatGPT оказался аккуратнее с причинностью. Второй ответ DeepSeek показал, что правильная арифметика может сочетаться с необоснованным управленческим советом.
Выбирать универсально лучшего аналитика по одной таблице нельзя. Практический вывод уже: просите модель показать формулы, отдельно перечислить допущения и отделить наблюдаемые факты от выводов о действиях. Затем проверяйте не только итоговое число, но и то, как из него получена рекомендация.