- Что такое Jev и зачем он появился
- Как устроен запрос к модели
- Какие данные Jev принимает
- Вероятность и уверенность без магии
- Почему модель быстрая и где проходит её граница
- Где Jev ошибается даже при правильном формате
- Где Jev пригодится на практике
- Как попробовать Jev
- Доступность, стоимость и ограничения
- Jev против обычных правил и языковой модели
- Итог
Jev выглядит необычно на фоне привычных нейросетей. Ему нельзя поручить написать статью или программу: он получает описание ситуации и набор вопросов, а возвращает варианты решений и вероятности. Разбираемся, когда такой подход действительно ускоряет автоматизацию, как с ним работать и почему правильный формат ответа ещё не гарантирует правильного решения.
Что такое Jev и зачем он появился
Jev — первая публичная модель класса System One компании TypeSafe AI. Её представили 15 сентября 2026 года. Компания предлагает использовать её внутри программ и ИИ-агентов для коротких решений: определить тип обращения, оценить срочность, выбрать следующий инструмент или отправить спорный случай человеку. Это отдельная задача по отношению к написанию текста. Приложению нужен не красивый абзац с объяснениями, а результат заранее известного типа, по которому можно выполнить следующее действие. Подробнее: Анонс TypeSafe.
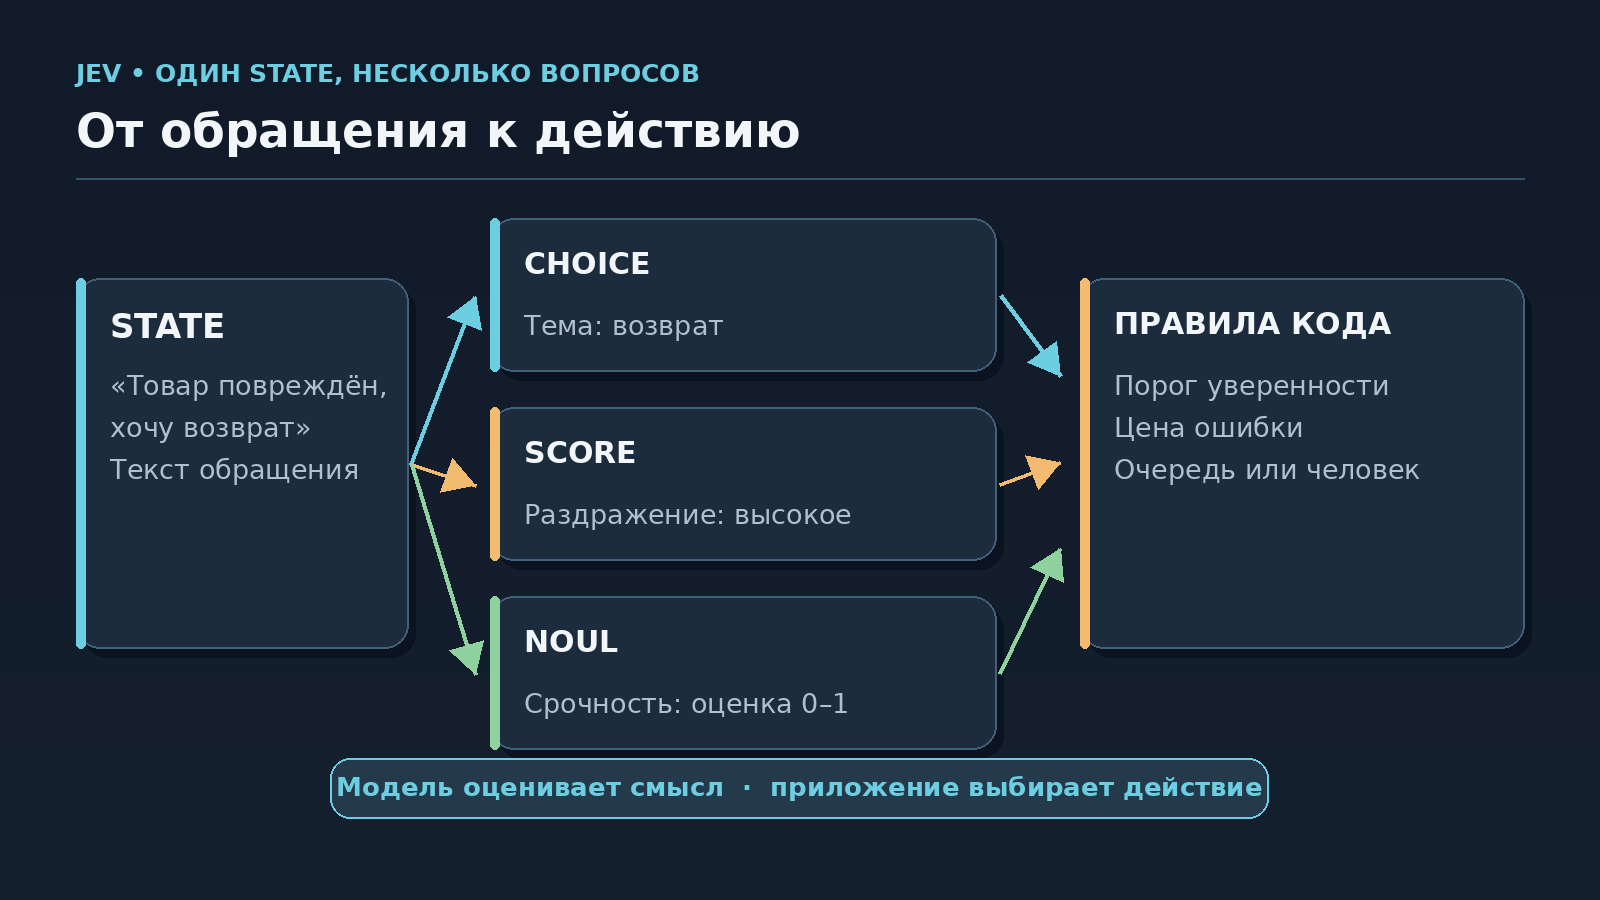
Представим службу поддержки. Клиент пишет, что посылка задержалась, товар оказался повреждён и он хочет возврат. Обычный чат-бот может сочинить ответ клиенту. Jev решает другую часть работы: отнести обращение к отделу возвратов, оценить раздражение клиента и определить, требуется ли срочная реакция. Дальше обычная программа применяет правила: создать заявку, назначить сотрудника и только затем, при необходимости, обратиться к языковой модели за текстом ответа.
Как устроен запрос к модели
В API передают state — описание ситуации — и список questions. Каждый вопрос формулирует одно небольшое суждение о той же ситуации. Jev возвращает ответ в структуре, которую программа может читать напрямую. Для этого TypeSafe предлагает три типа вопросов: Choice выбирает один из вариантов, Score оценивает состояние по заданной шкале, Noul выдаёт значение от 0 до 1 для утверждения вроде «Сообщение содержит просьбу о возврате». Подробнее: Типы вопросов в документации.
Choice может выбрать «возврат», «доставка» или «оплата» и показать распределение вероятностей между вариантами. Score пригодится для шкалы от спокойного обращения до крайне раздражённого. Noul удобен для отдельного признака, который нужен логике приложения. В одном обращении можно задать несколько вопросов; согласно документации TypeSafe, они оцениваются независимо и параллельно по одному и тому же state. Получив ответы, разработчик сам задаёт правила, которые соединяют их в действие.
Есть важное следствие: модель выбирает из заранее определённого набора. Если реальный запрос не укладывается в предложенные категории, аккуратная структура ответа не создаст подходящую категорию сама. В рабочем сценарии нужны возможность ручной обработки, подходящие варианты и правила для неоднозначных случаев. Вопрос «реши всё за меня» Jev подходит хуже, чем цепочка отдельных конкретных вопросов.
Какие данные Jev принимает
В актуальной документации указана версия Jev 1.13 с идентификатором jev-1.13.0. Она получает текст: строку, объект JSON или массив текстовых значений. Изображение, звук и видео нельзя передать ей как входные данные; сначала другой инструмент должен извлечь из них текст или нужные поля. Например, фотографию повреждённого товара сама Jev не рассмотрит, но сможет оценить текстовое описание проблемы, полученное от клиента или системы распознавания. Подробнее: Версия и форматы входа.
На один запрос отведено до 64 тысяч токенов суммарно для state и вопросов, при этом state вместе с самым длинным вопросом должны укладываться в 32 тысячи токенов. Это верхняя техническая граница, а не рекомендация передавать всю переписку целиком: лишние детали мешают модели выделить нужный сигнал. Английский остаётся основным языком обучения и самым точным по заявлению TypeSafe; для потока русскоязычных обращений качество решения надо оценивать отдельно. Компания также указывает, что не обучает Jev на запросах и ответах клиентов.
Вероятность и уверенность без магии
Для Choice и Score API возвращает вероятности по вариантам и поле confidence. В документации confidence описана как показатель того, насколько распределение сосредоточено на одном ответе; для Noul такого отдельного поля нет. Высокая уверенность означает, что один вариант заметно выделяется, но сама по себе не подтверждает, что он верен. Если системе недостаёт нужных данных, модель может уверенно выбрать плохой ответ. Подробнее: Как работает confidence.
Поэтому полезный сценарий строится вокруг последствий ошибки. Обычное обращение можно автоматически направить в нужный отдел. Возврат крупной суммы, удаление записи или блокировку пользователя разумно отправить на проверку. Для разных действий разработчик устанавливает разные пороги и при необходимости добавляет независимые проверки. Это достоинство формата Jev: приложение видит не только итоговый ярлык, но и сигнал о неопределённости.
Почему модель быстрая и где проходит её граница
Языковые модели обычно генерируют ответ последовательно, слово за словом. Jev не пишет свободный текст и выдаёт структурированные результаты для заданных вопросов. TypeSafe связывает с этим параллельную обработку и низкую задержку. На сайте компания приводит сравнение отдельных рабочих процессов: до 193,6 раза быстрее и до 444,6 раза дешевле выбранных альтернатив. Эти числа относятся к опубликованным ею сценариям, а не ко всем возможным задачам с ИИ.
Заявление о «нулевых галлюцинациях» тоже стоит читать точно. Модель не должна вернуть выдуманный текст вне заданной структуры или значение не того типа. Но она всё ещё может ошибиться в классификации, неверно понять контекст или переоценить уверенность. Для системы, которая действует в реальном мире, качество решения важнее идеального JSON. Jev устраняет один вид ошибок на границе между моделью и кодом, а не превращает любую оценку в факт.
Где Jev ошибается даже при правильном формате
В описании версии 1.13 TypeSafe отдельно предупреждает о задачах, которые модель решает хуже. Она ненадёжно сравнивает даты и время, считает точные количества и работает с числовой величиной по шкале Score. Если клиент пишет «доставить до 3 октября», модель может помочь извлечь дату из сообщения, но проверять, попадает ли она в допустимый срок, должен код. То же относится к подсчёту товаров и точным суммам. Подробнее: Слабые места Jev.
Сложные отрицания и цепочки косвенных условий тоже повышают риск ошибки. Чем больше в state посторонней информации, тем труднее ей выбрать верный ответ. Наконец, текст, который сам пользователь прислал для классификации, может содержать попытку повлиять на решение модели. Поэтому полезно сократить вход до относящихся к вопросу сведений, задавать прямые критерии и не превращать ответ Jev в единственное основание для необратимого действия.
Где Jev пригодится на практике
Первое применение — маршрутизация: распределять обращения клиентов, письма или задачи по отделам. Второе — наблюдать за агентом: решать, завершена ли задача, следует ли повторить действие и нужно ли вмешательство человека. Третье — обрабатывать документы в составе большего процесса: оценивать полноту данных, тип заявки и приоритет, оставляя окончательную проверку программным правилам и специалисту там, где цена ошибки высока.
Разработчик может соединять Jev с генеративной моделью. Одна модель объяснит сложный запрос и составит ответ, а Jev выберет одну из разрешённых ветвей рабочего процесса. Существующие правила при этом не исчезают: формальные условия вроде суммы, срока или наличия подписи лучше проверять обычным кодом. Jev полезен там, где решение зависит от смысла сообщения и его трудно свести к поиску точного слова.
Для читателя без опыта программирования самостоятельная польза ограничена. У Jev есть Playground для знакомства с принципом работы, однако полноценное применение требует API, проектирования вопросов и логики, которая обрабатывает результат. В отличие от ChatGPT, это не готовый помощник с привычным чатом.
Как попробовать Jev
На сайте TypeSafe доступен Playground: в него можно вставить пример сообщения, задать один или несколько вопросов и увидеть ответы. Удобно начать с задачи, где правильное действие известно заранее. Например, создать три категории обращений магазина, добавить признак срочности и проверить случаи с двумя темами сразу. Не стоит сразу переносить результат в автоматическое действие: сначала полезно посмотреть, какие запросы модель путает и что делает с неясной формулировкой.
Для приложения нужен ключ API. В официальном кратком руководстве показан POST-запрос на api.typesafe.ai/v1/systemone с полями state, model и questions. Для языка Python и JavaScript доступны официальные SDK. Разработчику придётся обработать ответ и определить: когда принять решение автоматически, когда собрать дополнительные сведения, а когда передать вопрос человеку. В этой точке и находится основная работа по внедрению. Подробнее: Пример API-запроса.
Доступность, стоимость и ограничения
На странице актуальной версии Jev 1.13 указана цена 0,042 доллара за миллион входных токенов; выходные токены не тарифицируются. Это цена модели, а не готового сервиса поддержки: инфраструктура, другие модели, разработка и проверки оплачиваются отдельно. Для небольшого знакомства есть Playground, а для рабочего приложения потребуется учётная запись и API-доступ. Если пороги решений подобраны под определённую версию, её идентификатор лучше закрепить в настройках: псевдоним jev-latest перейдёт на новый релиз автоматически.
Есть и ограничения по типу задачи. Jev не предназначен для написания произвольных текстов, многошагового исследования и генерации кода. Сложное решение лучше разделить на маленькие вопросы, а недостающую информацию получить до вызова модели. Утверждения о скорости и цене особенно интересны при большом количестве повторяющихся решений; в единичном ручном сценарии выигрыш может оказаться незаметным.
Jev против обычных правил и языковой модели
Если задачу можно однозначно выразить условием «сумма больше 10 000 — отправить на согласование», обычный код проще и надёжнее. Если нужен подробный ответ клиенту, статья или фрагмент программы, нужна генеративная языковая модель. Jev занимает промежуточное место: он помогает превратить смысл неструктурированного сообщения в ограниченный набор решений, а программа управляет дальнейшими действиями.
Такая специализация делает Jev любопытным направлением для агентных систем. Вместо того чтобы поручать одной большой модели каждую микропроверку, разработчик может распределить работу между правилами, моделью решений и генеративной моделью. Результат зависит от того, насколько хорошо продуманы категории, пороги и действия после ответа.
Итог
Jev полезен как быстрый слой ограниченных решений при большом потоке обращений. Он выдаёт строгий ответ, но качество маршрутизации зависит от категорий, порогов и проверок. Playground поможет познакомиться с подходом; в значимых случаях человеку нужно оставить последнее слово.