- Что именно означает корректный JSON
- Сначала фиксируем контракт данных
- Почему null не заменяет пропущенный ключ
- Схема для двадцати записей
- Роль промпта в подготовке JSON
- Как прошёл один реальный ответ ChatGPT
- Как выполнялась локальная проверка
- Что показали шесть испорченных копий
- Настройки парсера и проверки дат
- Что делать после ошибки
- Чеклист перед использованием файла
Ответ нейросети может выглядеть как аккуратный JSON и всё равно сломать импорт. Число иногда оказывается строкой, обязательный ключ исчезает, а дата остаётся формально правильной, но относится не к тому событию. Просьба «верни корректный JSON» не заменяет проверку полученного файла.
Надёжный порядок работы: сначала разобрать текст парсером, затем проверить структуру по JSON Schema, после этого сверить значения с исходником и правилами задачи. Покажем такой процесс на одном реальном ответе ChatGPT с 20 вымышленными мероприятиями и шести отдельно подготовленных повреждённых копиях эталона. Видимый текст ответа прошёл проверку, а содержимое кнопки «Копировать» оказалось непригодным для прямого разбора. Этот разбор показывает конкретный результат и работу проверяющего кода, а не общую точность модели.
Что именно означает корректный JSON
Есть три разных вопроса, которые часто смешивают.
Первый: можно ли прочитать текст как JSON? Лишняя запятая после последнего элемента, одинарные кавычки и комментарии нарушают синтаксис. Пояснение «Вот ваш JSON» перед массивом тоже мешает обработать весь ответ как один документ. Правила самого формата описаны в RFC 8259.
Второй: соответствует ли прочитанный документ договорённой структуре? Массив вместо объекта, строка “24” вместо числа 24 и пропущенное поле вполне могут быть допустимым JSON, но не подходить конкретному импортёру. Здесь нужна схема.
Третий: верны ли данные? Дата окончания 2026-11-01 имеет правильный формат. Но если мероприятие начинается 2026-11-02, она противоречит правилу расписания. А число 25 вместо 24 может пройти и синтаксис, и схему, оставаясь ошибкой переноса.
Поэтому надпись «JSON валиден» имеет смысл только вместе с уточнением: прошёл разбор, соответствует такой-то схеме или ещё и сверен с источником.
Сначала фиксируем контракт данных
Для примера нужно перенести расписание учебных мероприятий из текстовых строк в массив из 20 объектов. В каждом объекте семь ключей:
- id: строковый идентификатор, например EV01;
- title: непустая строка с названием;
- start_date и end_date: строки с датами YYYY-MM-DD;
- seats: неотрицательное целое число;
- online: логическое значение true или false;
- note: строка с примечанием либо null, если сведений нет.
Все ключи обязательны. Дополнительные поля запрещены. Порядок мероприятий сохраняется. Ноль мест означает именно ноль, а не отсутствие данных. Окончание не может быть раньше начала; идентификаторы не должны повторяться.
Так выглядит первая запись эталонного файла:
{
  "id": "EV01",
  "title": "Основы композиции",
  "start_date": "2026-11-02",
  "end_date": "2026-11-02",
  "seats": 24,
  "online": true,
  "note": null
}
Это фрагмент, а не весь массив. Полный учебный набор содержит 20 мероприятий, в том числе записи с нулём мест, онлайн- и очным форматом, отсутствующим примечанием и переходом даты окончания в следующий месяц. Здесь нет персональных данных и реальных записей участников.
Почему null не заменяет пропущенный ключ
В JSON null является отдельным значением. Отсутствие свойства означает, что пары «ключ: значение» в объекте вообще нет. Это разные состояния, что отдельно подчёркивает документация JSON Schema.
Для нашего контракта получаются четыре варианта:
- “note”: null подходит: ключ есть, отсутствие сведений обозначено явно;
- отсутствие note не подходит: нарушен список обязательных ключей;
- “note”: “null” проходит проверку типа строки, но не соответствует исходнику с отметкой «нет данных»;
- “title”: null не подходит: для названия разрешена только строка.
Пустая строка “” тоже не равна null. Если импортёр трактует её иначе, правило нужно описать заранее. Не стоит просить модель «заполнить пропуски разумно»: так задача переноса незаметно превращается в задачу выдумывания недостающих сведений.
Схема для двадцати записей
JSON Schema описывает ограничения на документ. В нашем примере указан диалект Draft 2020-12. На верхнем уровне разрешён только массив, а minItems и maxItems одновременно заданы равными 20. Схема items применяется к каждой записи. Назначение этих ограничений описано в справочнике по массивам.
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "type": "array",
  "minItems": 20,
  "maxItems": 20,
  "items": {
    "type": "object",
    "required": ["id", "title", "start_date",
                 "end_date", "seats", "online", "note"],
    "additionalProperties": false,
    "properties": {
      "id": {"type": "string", "pattern": "^EV[0-9]{2}$"},
      "title": {"type": "string", "minLength": 1},
      "start_date": {"type": "string", "format": "date"},
      "end_date": {"type": "string", "format": "date"},
      "seats": {"type": "integer", "minimum": 0},
      "online": {"type": "boolean"},
      "note": {"type": ["string", "null"]}
    }
  }
}
Здесь required требует присутствия ключей, а properties описывает их значения. Одно не заменяет другое. Если перечислить поля только в properties, это не сделает их обязательными. Дополнительные свойства по умолчанию разрешены; запрет в данном контракте задаёт additionalProperties: false. Эти различия разобраны в справочнике по объектам.
Схема намеренно не знает конкретного расписания. Она пропустит EV99, если такой идентификатор подходит шаблону, и число мест 25 вместо 24. Такие ошибки обнаружит сверка с исходником. Уникальность идентификатора тоже проверяется отдельно: uniqueItems сравнивает элементы массива целиком, а не только выбранное поле id.
Роль промпта в подготовке JSON
В запросе стоит перечислить обязательные поля, разрешённые типы, правила преобразования и формат ответа. Ниже сокращённый вариант инструкции без исходных строк. Полный запрос с 20 мероприятиями входит в приложение:
Преобразуй 20 учебных мероприятий из исходных данных в JSON.
Верни только один JSON-массив, без Markdown-ограждений,
вступления и комментариев. Сохрани порядок и значения.
Не добавляй, не исправляй и не угадывай факты.

Ключи id, title, start_date, end_date: строки.
Даты сохраняй в формате YYYY-MM-DD.
seats: неотрицательное целое число без кавычек.
online: true для «да», false для «нет».
note: текст либо JSON null для [нет данных].
Ключ note обязателен. Строку "null" не используй.
Все семь ключей обязательны. Другие ключи запрещены.
Ровно 20 записей. Сохрани кириллицу.

Далее идут исходные данные.
Полезно приложить и схему, особенно когда контракт сложнее этого примера. Но эталонные значения для проверки нужно сохранить отдельно до отправки запроса. Если попросить ту же модель придумать данные, схему и оценить собственный ответ, ошибки могут совпасть во всех трёх частях.
Первый ответ сохраняют без правок. Если модель обернула JSON в Markdown или добавила вступление, это отдельный результат проверки формата. После извлечения массива можно проверить и очищенный вариант, но уже как другой файл. Нельзя незаметно починить ответ и потом объявить, что первая попытка прошла проверку.
Как прошёл один реальный ответ ChatGPT
24 октября 2026 года в 15:54 UTC полный запрос с 20 исходными строками отправили в веб-интерфейсе ChatGPT. Был один запрос и один первый ответ, без перегенераций и просьб исправить результат. Сохранённый текст запроса совпал с заранее подготовленным файлом; единственное байтовое отличие: в конце не было завершающего перевода строки.
В интерфейсе были выбраны GPT-6 и Medium. При этом в доступном представлении интерфейса присутствовало сообщение «Достигнут лимит использования». Какая модель фактически обслужила запрос на сервере, независимо не подтверждалось. Поэтому результат ниже относится к этой сессии и этому ответу, а не доказывает характеристики GPT-6.
Сохранили два представления одного ответа. Первое: дословное содержимое буфера после кнопки «Копировать». Второе: отдельно прочитанный видимый текст контейнера ответа, innerText. Ни из одного файла не удаляли символы и не меняли значения.
Результаты различались:
- Файл из буфера не прошёл даже парсер. Сообщение: Expecting value: line 1 column 2 (char 1). После открывающей скобки в нём присутствовала обратная косая черта; далее встречались буквальные сущности . Схема и последующие проверки для него не запускались.
- Видимый текст прошёл парсер, JSON Schema с проверкой форматов, правила идентификаторов и дат, а затем сверку с эталоном. Совпали все 140 значений в 20 записях; порядок записей сохранился. Код завершения проверки: 0.
Это не история о том, как неправильный ответ «починили» до правильного. Два файла получены разными способами из одного и того же ответа. Подтверждено различие представлений, но его точную причину на стороне сервиса мы не устанавливаем. Файл из буфера не является серверным или API-экспортом, поэтому приписывать его экранирование самой модели нельзя.
Практический вывод: проверять нужно именно тот файл, который пойдёт в импорт. Читаемый JSON на экране и результат копирования не всегда совпадают побайтно. Успех видимого текста не превращает непрошедший проверку файл из буфера в готовый импортный файл.
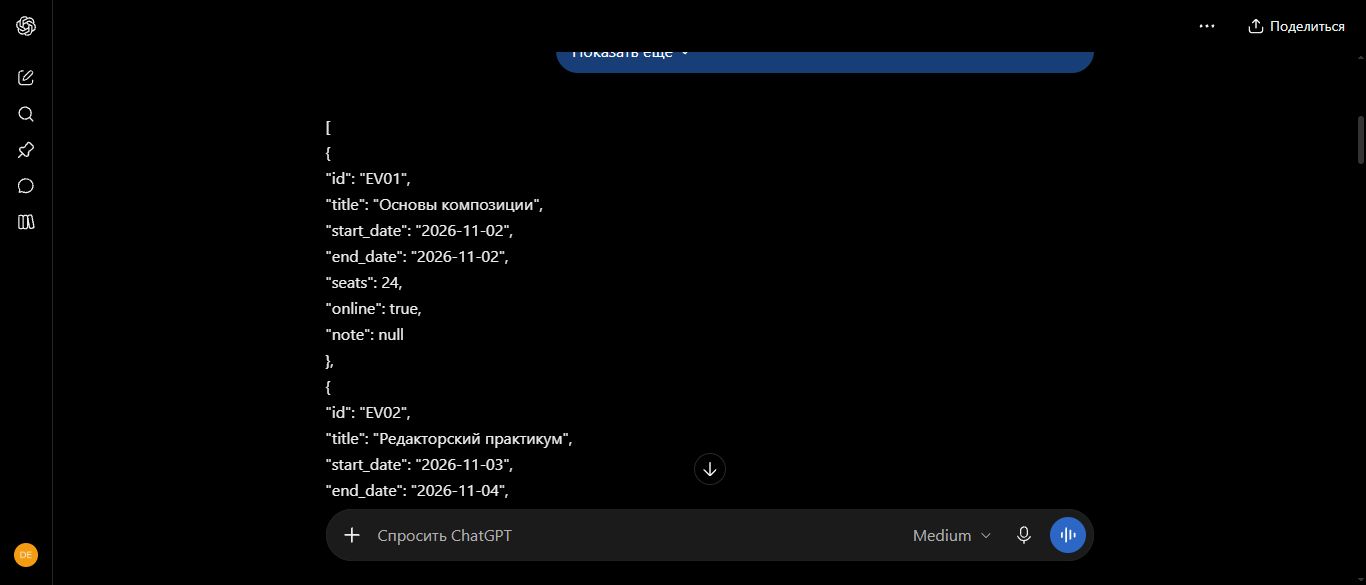
Фрагмент реального скриншота начала ответа, 24 октября 2026 года, 15:58:29 UTC. На экране видны значения первой записи и режим Medium. Кадрирование выполнено только для читаемости; исходный снимок сохранён.
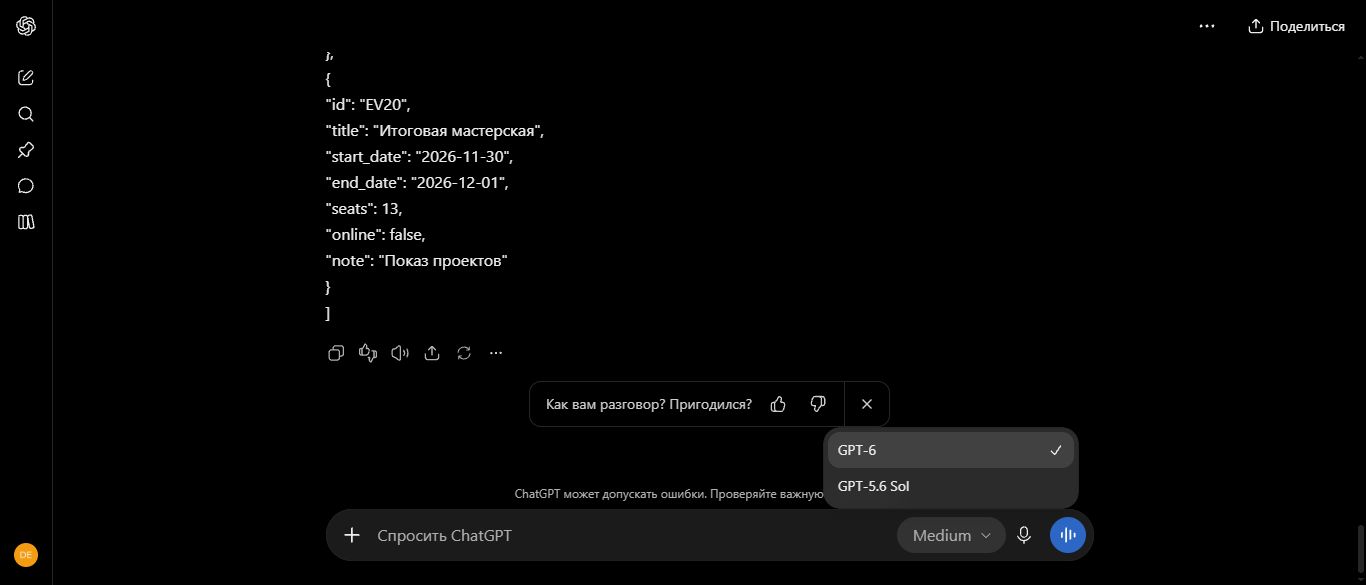
Фрагмент реального скриншота, 24 октября 2026 года, 15:57:05 UTC. Видны конец массива, выбранные в интерфейсе GPT-6 и Medium. Выбор интерфейса не подтверждает серверную модель. Исходный снимок сохранён.
Как выполнялась локальная проверка
Для запуска использовались Python 3.12.14 и установленная библиотека jsonschema 4.26.0. Схема, исходные 20 записей, эталонный массив и ожидаемые результаты были записаны до теста. Их SHA-256 сохранены в манифесте; перед прогоном скрипт проверил, что файлы не изменились.
Контрольные копии создавались из одного эталона. В каждой менялась ровно одна вещь: запятая, обязательное поле, тип, допустимость null, лишний ключ или дата окончания. Это семь файлов по 20 записей, а не 26 независимых ответов нейросети.
Порядок проверки в скрипте:
- Проверить саму схему через check_schema.
- Прочитать весь текст как один JSON-документ.
- Проверить документ валидатором Draft202012Validator с включённым FormatChecker.
- Если схема пройдена, проверить неповторяемость id и порядок дат.
- Сравнить каждое значение и порядок записей с заранее сохранённым эталоном.
При синтаксической ошибке следующие этапы не выполнялись. При ошибке схемы бизнес-проверки также останавливались. В отчёте такое состояние обозначено как «не запускалось», а не как успешная проверка.
Ядро схемной проверки выглядит так:
import json
from jsonschema import Draft202012Validator, FormatChecker

with open("schema.json", encoding="utf-8") as f:
    schema = json.load(f)

Draft202012Validator.check_schema(schema)
validator = Draft202012Validator(
    schema, format_checker=FormatChecker()
)

# data уже получен отдельным шагом строгого разбора JSON.
errors = list(validator.iter_errors(data))
for error in errors:
    print(list(error.absolute_path), error.message)
Это фрагмент, отвечающий только за схему. Он не включает чтение проверяемого ответа и бизнес-правила; полный воспроизводимый скрипт вынесен в приложение. check_schema нужен, чтобы не проверять данные по ошибочно составленному контракту. iter_errors возвращает обнаруженные нарушения, а не только первое. Оба механизма описаны в документации jsonschema.
Что показали шесть испорченных копий
| Файл | Изменение | Разбор JSON | Схема | Правила и исходник |
|---|---|---|---|---|
| Эталон | Без изменений | Пройден | Пройдена | Пройдены |
| M01 | Запятая после последнего элемента | Ошибка | Не запускалась | Не запускались |
| M02 | Удалён ключ note | Пройден | Ошибка required | Не запускались |
| M03 | seats: “24” вместо 24 | Пройден | Ошибка type | Не запускались |
| M04 | title: null вместо строки | Пройден | Ошибка type | Не запускались |
| M05 | Добавлен ключ debug | Пройден | Ошибка additionalProperties | Не запускались |
| M06 | Окончание раньше начала | Пройден | Пройдена | Ошибка даты и несовпадение с исходником |
Все семь результатов совпали с заранее заданными ожиданиями. Парсер отсеял одну повреждённую копию; схема отсеяла ещё четыре; шестая дошла до бизнес-проверки и сверки значений. Эталон прошёл все этапы.
Наиболее показателен M06. Для первой записи дату окончания заменили с 2026-11-02 на 2026-11-01. Обе строки представляют существующие календарные даты, поэтому схема не возражала. Отдельная проверка обнаружила end_date precedes start_date, а сравнение с эталоном указало путь /0/end_date и различие двух значений.
Эта демонстрация не даёт процента надёжности нейросети. Ошибки внесены вручную и заранее известны. Результат подтверждает только то, что конкретный проверяющий код обнаружил предусмотренные дефекты на данном наборе.
Настройки парсера и проверки дат
Первая касается дат. В jsonschema проверка format без явно подключённого FormatChecker не выполняется. Само наличие “format”: “date” в схеме ещё не гарантирует отказ для невозможного дня. Мы отдельно подставили 2026-02-30: без FormatChecker документ прошёл схему, с ним был отклонён. Это согласуется с описанием format в JSON Schema.
Вторая касается парсера Python. Его json.loads по умолчанию допускает NaN и бесконечности, а при повторяющихся именах свойств сохраняет последнее значение. Для нашего импортного контракта добавлены две защиты: parse_constant отклоняет нестандартные числовые константы, object_pairs_hook отклоняет повтор ключа. Поведение и точки расширения описаны в документации модуля json.
При этом повтор ключа мы называем нарушением политики импорта, а не любой ценой «синтаксической ошибкой JSON»: RFC рекомендует уникальные имена, но разные реализации обрабатывают повторы по-разному. Важно явно выбрать поведение, а не потерять первое значение молча.
Ещё одна тонкость: integer в JSON Schema означает целочисленное значение. Число 24.0 в нашей проверке прошло этот тип; строка “24” не прошла. Это соответствует определению числовых типов. Если принимающая система требует именно запись без десятичной точки, одной проверки integer для такого лексического ограничения недостаточно.
Что делать после ошибки
Не нужно отправлять модели расплывчатое «JSON неправильный, исправь». Передайте конкретный путь, нарушенное правило и исходное значение. Например: «В /0/seats получена строка “24”. По контракту нужно целое число 24. Верни весь массив, сохрани остальные значения».
Сохраните исправленный ответ отдельно и прогоните все проверки заново. Исправление одного места может изменить соседнее. Исходный ответ, новая версия и отчёты должны оставаться различимыми.
Если схема успешно пройдена, но содержание расходится с исходником, ослаблять схему бессмысленно. Нужно восстановить правильное значение. Если же допустимый по бизнес-смыслу вариант отвергнут, сначала уточняют контракт импортёра, затем согласованно меняют схему и тесты. Правило не стоит менять только ради зелёного результата.
Для регулярного импорта полезнее автоматический отказ с понятной ошибкой, чем молчаливое преобразование любого похожего ответа. В учебном скрипте успешное завершение возвращает код 0, а нарушение хотя бы одного проверяемого условия при проверке отдельного файла возвращает код 1.
Чеклист перед использованием файла
- Есть сохранённый исходник и независимо подготовленный эталон либо проверяемые правила сверки.
- Зафиксированы версия схемы, обязательные поля, типы, null и политика лишних ключей.
- Проверен весь ответ, а не только визуально выбранный фрагмент.
- Схема сама прошла проверку и использован нужный диалект.
- Проверка форматов действительно включена, а не только указана в JSON.
- После схемы проверены связи между полями, идентификаторы и соответствие источнику.
- Ошибки и повторные попытки сохранены раздельно.
Главный вывод: просить нейросеть соблюдать формат полезно, но доверять импорт данных стоит проверяющему коду. Парсер защищает от сломанной записи, схема от неправильной структуры, а сверка с источником от правдоподобных, но чужих значений.